Aumente sua capacidade de throughput sem sair do dashboard
Autor: Uttam Singh
Um lançamento, uma mintagem ou um backfill de indexação podem levar um app além da sua capacidade de throughput em menos de um minuto. A boa notícia é que, nos planos pagos, sua equipe agora pode aumentar essa capacidade sozinha, sem falar conosco. Abra a página Usage no seu dashboard, escolha a capacidade extra necessária e confirme. A nova base é aplicada em segundos.
Você pode cancelar o add-on pelo dashboard quando quiser. A capacidade adicionada permanece ativa até o fim do período de cobrança atual, e depois sua equipe volta à sua capacidade de throughput base.
O que é capacidade de throughput?
Throughput é a velocidade com que você pode nos enviar requests, medida em unidades de computação por segundo (CU/s). Medimos o custo total das suas requests em vez do número bruto de requests, porque cada método RPC tem seu próprio custo em unidades de computação, dependendo de quanto trabalho é necessário para atendê-lo.
Dimensionar a necessidade de capacidade exige um pouco mais do que somar esses custos. A tabela de custos tem uma coluna CU e uma coluna separada Throughput CU, e para alguns métodos os dois valores diferem, então uma chamada que é barata em relação ao seu uso mensal ainda pode ser cara em relação ao seu throughput. Use a coluna Throughput CU para dimensionar sua capacidade.
- A capacidade é alocada no nível da conta, não por app. O throughput costumava ser configurado por app e agora é configurado para toda a sua conta, então o uso combinado de todos os apps da sua equipe conta para um único número. Criar um segundo app não te dá mais margem.
- Medimos em uma janela móvel de 10 segundos. Nossa documentação de throughput descreve um token bucket avaliado ao longo de 10 segundos, então um limite de 10.000 CU/s te dá 100.000 unidades de computação em qualquer intervalo de 10 segundos. Uma rajada curta passa, enquanto o tráfego que permanece acima do limite volta da nossa camada de edge como um HTTP 429 (too many requests).
A janela importa mais do que o número em si. Uma carga de trabalho pode ficar confortavelmente abaixo do seu limite na média e ainda assim ser limitada no pico, e é por isso que um 429 costuma surpreender a equipe que recebe um.
Como funciona o upgrade de throughput?
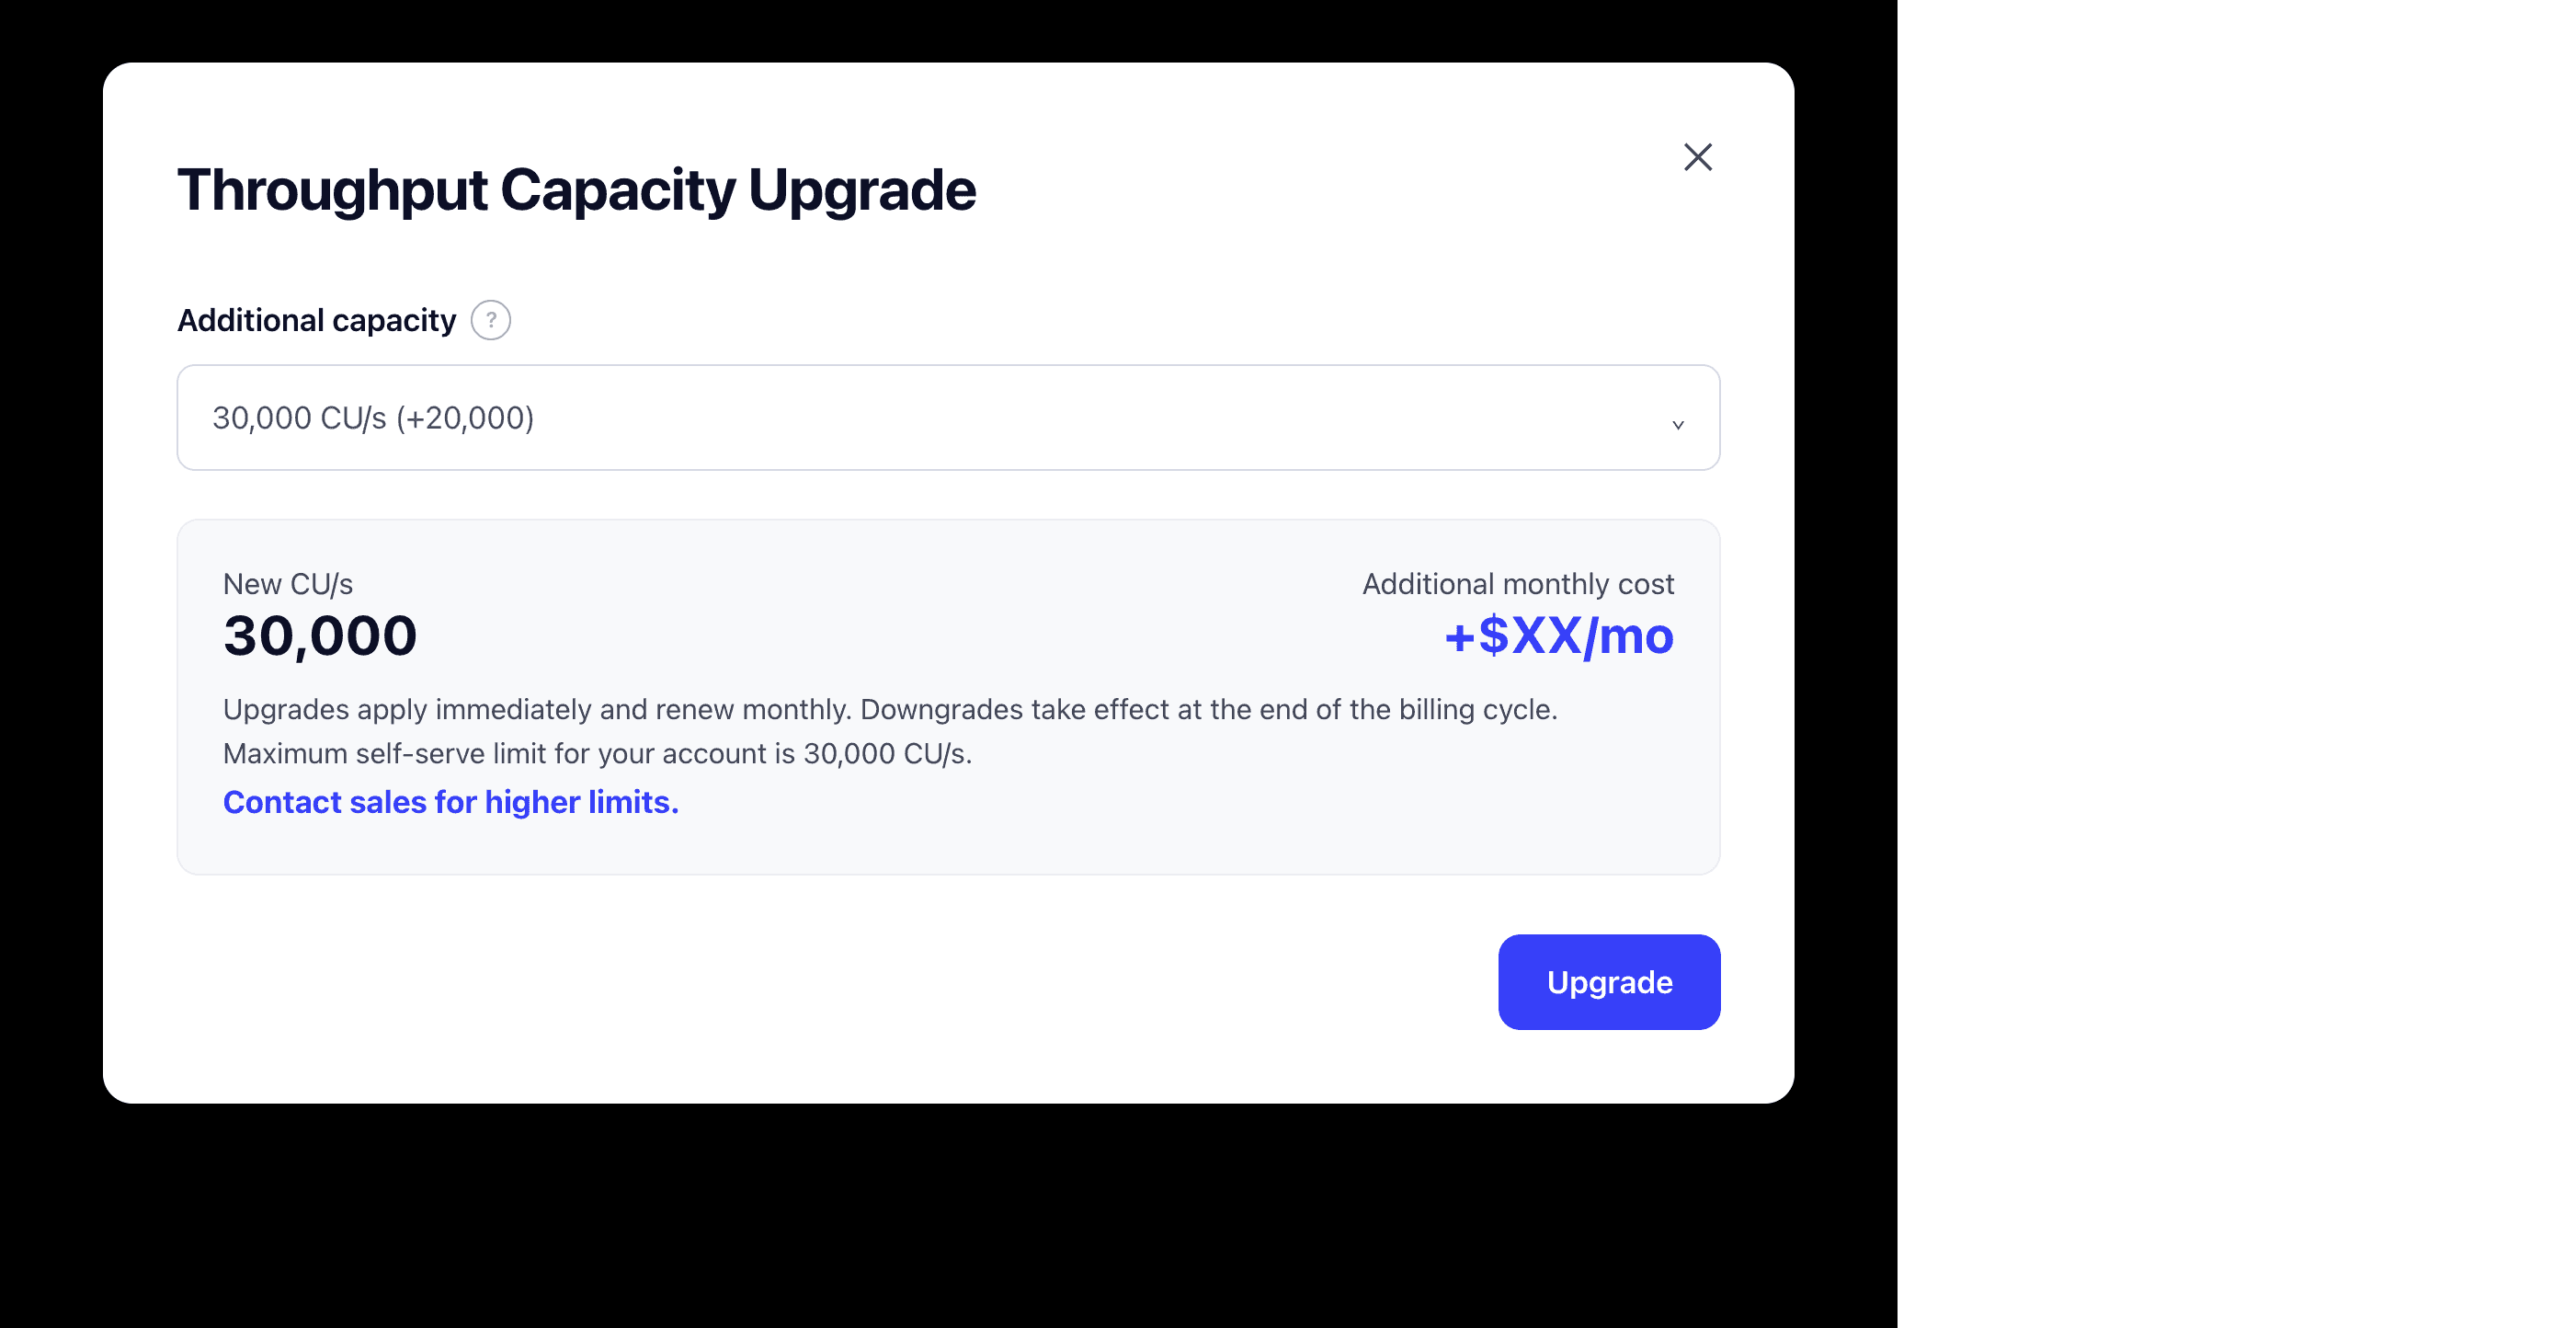
Abra a página Usage no seu dashboard, encontre a seção de throughput e escolha Upgrade limit. Você precisa ser um billing admin na sua equipe para ver esse controle. O dropdown de capacidade lista cada incremento com o preço mensal ao lado, então você vê o custo antes de se comprometer com qualquer coisa. A mesma página mostra um banner quando o uso recente da equipe excedeu sua capacidade de throughput atual, e clicar nele te leva direto ao fluxo de upgrade.
O que acontece depois que você confirma:
- Upgrades se aplicam imediatamente e renovam mensalmente. A nova capacidade é aplicada em segundos após a confirmação.
- Downgrades entram em vigor no fim do ciclo de cobrança. Se você cancelar, a capacidade extra permanece ativa até lá, então um backfill que demora mais que o previsto não cai de repente.
- Quando não resta nenhum incremento self-serve completo, o dashboard te direciona a falar com o time de vendas. Nosso time pode configurar um limite de throughput maior do que o oferecido como self-serve no dashboard.
Até onde você pode ir depende do seu plano:
Equipes pay-as-you-go começam com 10.000 CU/s e chegam a 30.000 CU/s por conta própria, sem contrato Enterprise e sem formulário de pedido. A capacidade inicial do Enterprise é definida por contrato, então a linha de base varia de conta para conta. O modal de upgrade mostra o máximo exato para sua equipe, e você sobe em direção a ele em incrementos fixos enquanto ainda couber um incremento completo abaixo dele.
Então qualquer coisa abaixo da capacidade máxima de upgrade self-serve do seu plano é uma decisão que sua equipe toma sem precisar de nós, em menos de um minuto, desde que quem tome a decisão seja um billing admin.
De quanto throughput você realmente precisa?
Comece pelo card e pelo gráfico de pico de throughput na página Usage, não pela média. As médias suavizam os picos e acabam te convencendo a definir um limite que pode falhar no seu próximo lançamento.
Trate esse pico como um piso, não como uma leitura exata. Aplicamos o limite ao longo de dez segundos, mas o gráfico plota médias de um minuto, então a rajada que de fato disparou um 429 fica achatada dentro do minuto ao redor dela e aparece mais baixa do que realmente foi. Para descobrir se esses picos custaram requests ou apenas chegaram perto disso, filtre os Request Logs por respostas 429.
Essa diferença entre as duas janelas é a maior parte do argumento para comprar margem acima do pico em vez de apenas igualá-lo. Um tráfego que atingiu o pico de 12.000 CU/s uma vez vai atingir um pico ainda maior eventualmente, e margem é mais barata do que um incidente.
Retries e mais throughput resolvem problemas diferentes, então ajuda saber qual problema você tem:
- Retries são adequados para uma pequena fração de 429s e para fluxos que toleram latência extra. Nossa documentação cobre Retry-After headers e exponential backoff exatamente para esse caso.
- Mais throughput é a resposta para caminhos sensíveis à latência e para tráfego que fica sustentado acima do seu limite, em vez de apenas ultrapassá-lo brevemente. Nenhuma estratégia de backoff resolve uma carga de trabalho que simplesmente precisa de mais capacidade do que tem.
Três tipos de carga de trabalho motivam a maioria dos upgrades: crescimento sustentado à medida que um app ganha usuários, backfills de indexação que puxam histórico o mais rápido que o endpoint permite, e eventos programados como airdrops, lançamentos de tokens e mintagens. O primeiro é permanente e os outros dois são temporários, e é por isso que o fluxo oferece suporte a cancelar com a mesma facilidade com que oferece suporte a comprar.
Quando você deve falar conosco em vez disso?
O self-serve cobre os casos comuns, não todos os casos. Entre em contato quando:
- Você já passou do máximo self-serve do seu plano e ainda está crescendo.
- Você quer negociar o throughput em um contrato, em vez de pagá-lo como um add-on mensal.
- Uma única chain, app ou método na sua carga de trabalho tem picos muito mais altos que o restante, de modo que um throughput personalizado seria mais adequado do que uma capacidade única para toda a equipe.
Essas são conversas sobre volume e estrutura, e nosso time de especialistas pode conduzi-las. Comprar 5.000 CU/s de margem para passar por um pico é uma decisão menor, então ela fica no dashboard, onde você pode tomá-la no seu próprio ritmo.
Obtenha mais throughput em segundos
Aumente sua capacidade pelo Alchemy dashboard hoje mesmo. Basta um dropdown, e a aplicação é imediata, sem mudança de contrato. Se você ainda não está em um plano pago, nossa RPC API começa de graça e o pay-as-you-go pricing não tem compromisso mínimo, então o caminho de upgrade está aberto desde o seu primeiro dia faturável.
Para ver para onde seu tráfego realmente está indo, o Alchemy Monitor reúne volume de requests, erros e latência em um só lugar, e você pode obter os mesmos dados de uso pelo Alchemy CLI.
Vai escalar além do que o self-serve cobre? Fale com nosso time de vendas sobre volume pricing, e nós dimensionaremos a capacidade necessária de acordo com o tráfego que você realmente espera.
Newsletter da Alchemy
Seja o primeiro a saber sobre lançamentos
Assine nossa newsletter
Receba as últimas atualizações de produtos e recursos da Alchemy
Ao inserir seu endereço de e-mail, você concorda em receber nossas comunicações de marketing e atualizações de produtos. Você reconhece que a Alchemy processa as informações que recebemos de acordo com nosso Aviso de Privacidade. Você pode cancelar a inscrição a qualquer momento.

Artigos relacionados

Por que equipes de trading escolhem a Alchemy para RPC de baixa latência
Equipes de trading escolhem a Alchemy por leituras e escritas de baixa latência quando o mercado se move, e por um registro confiável quando o dinheiro liquida, mesmo no pico de volume.

Em qual provedor de RPC você deve construir em Tóquio?
Comparamos cinco dos provedores de RPC que atendem Tóquio em cinco chains. Veja como eles se comparam e onde as diferenças importam para equipes sensíveis à latência.

Arquitetando leituras Solana RPC para velocidade e confiabilidade líderes do setor
A Alchemy tem a menor latência de leitura Solana: 9,21 ms, cerca de 26% mais rápido que o próximo provedor.