アーカイブノード - 知っておくべきこと

執筆者 Alchemy
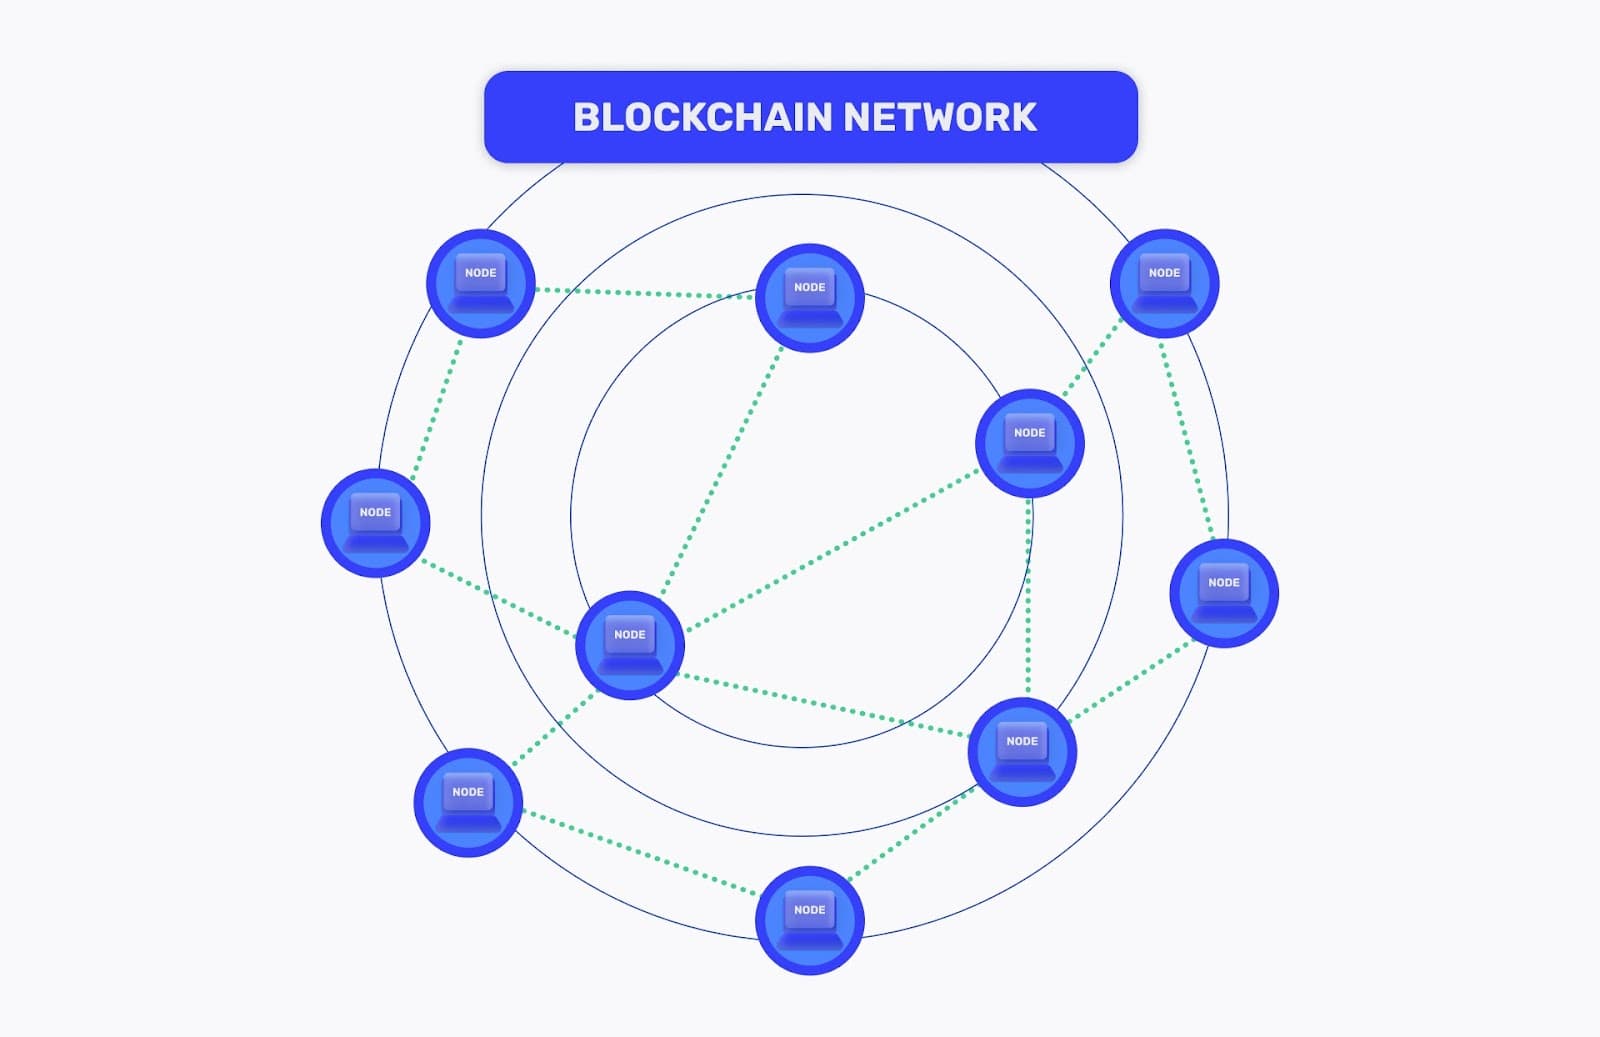
Ethereum やPolygonのようなパブリックブロックチェーンは、コンピュータで構成されるグローバルなピアツーピアネットワークです。各ピアデバイスはノードと呼ばれ、ブロックチェーン上の情報を保存・処理し、ネットワークの状態を検証するなどの役割を担っています。
ノードはブロックチェーン上の他のピアと通信できますが、それぞれ異なる機能とユースケースを持っています。例えば、本記事で扱うアーカイブノードは、ブロックチェーンの完全な履歴データを保存し、要求に応じて提供できます。これは、最近のブロックチェーンの状態のみを保存するフルノードや、主にフルノードからデータを要求するライトノードとは異なります。
この概要では、アーカイブノードについて詳しく解説し、Ethereumにおける仕組みを説明します。アーカイブノードを稼働させることが重要な理由、使用すべきクライアント、そして過去のブロックチェーンデータを照会するためのアーカイブノードの構築方法について学びます。
Ethereumアーカイブノードとは?
Ethereumアーカイブノードとは、ジェネシスブロック(最初に作成されたブロック)に至るまで、ブロックチェーンの全履歴を保存する能力を持つフルノードです。ノードについてはブロックチェーンノードのガイドで詳しく説明していますので、ここでは各タイプの概要を簡単に紹介します。
フルノード
フルノードは現在および最近のブロックチェーンの状態(直近128ブロックまで)を保存し、新たに追加されるブロックの検証に参加します。トランザクションの処理、スマートコントラクトの実行、ブロックチェーンデータの照会・提供が可能です。また、(トレースを介して)一部の履歴データにアクセスすることもできますが、この用途には非効率的です。
ライトノード(「ライトクライアント」とも呼ばれる)
ライトクライアントはブロックヘッダーのみを保存し、最小限のブロックチェーンデータ(ブロックのタイムスタンプ、ハッシュ、マイニング難易度など)へのアクセスを持ちます。ただし、フルノードと連携して必要なデータを取得し、情報を検証すること(トランザクションステータスの確認や残高の照会など)も可能です。ライトノードの稼働は、ハードウェア投資、運用コスト、技術的専門知識の面で最も負担が少なくなります。
アーカイブノード
アーカイブノードはフルノードと同じ情報に加え、ブロックチェーンの過去のすべての状態を保存します。アーカイブノードの稼働には、ハードウェア投資、運用コスト、技術的専門知識、経験の面で最も大きな負担が必要になります。アーカイブノードはアーカイブブロックチェーンデータを迅速かつ効率的に構築し、特定のブロックにおけるユーザーの残高といった任意の過去データを照会する際に有用です。
アーカイブノードは他のノードよりも多くのストレージ容量を必要とします(保存するデータ量が多いため)が、特定のケースではその投資に見合う価値があります。次のセクションでは、アーカイブノードの仕組みと、そのアーキテクチャが他のノードタイプとどう異なるかを見ていきます。
アーカイブノードはどのように機能するのか?
アーカイブノードは、ブロック間のブロックチェーンの全履歴状態を保存します。アーカイブノードは基本的に、異なる時点でのネットワークのスナップショット群を含んでいます。
アーカイブノードはどのデータを同期するのか?
アーカイブノードは「フルシンク」を実行し、ジェネシスブロックからブロックヘッダー、トランザクション、レシートを含む完全なブロックデータをダウンロードします。
すべてのノードと同様に、アーカイブノードもネットワーク上でデータを保存・検証するために、ブロックチェーンの現在の状態と「同期」する必要があります。同期には、ピアから状態データを復元し、トランザクションを検証し、ブロックチェーンのローカルインスタンスを構築することが必要です。
アーカイブノードは、ダウンロードしたすべてのブロックを検証し、すべてのトランザクションを再実行し、すべての中間状態をディスクに書き込みます。この最後の部分が、アーカイブノードが異なる時点でのブロックチェーンの状態の「アーカイブ」を提供する理由です。
アーカイブノードの同期にはどれくらい時間がかかるのか?
アーカイブノードの同期にかかる平均的な時間の見積もりは様々ですが、1ヶ月から3ヶ月程度(問題が発生した場合はそれ以上)を見込んでおくべきです。
アーカイブノードの同期には通常のフルノードやライトクライアントよりも長い時間がかかります。これは単純に、アーカイブノードが誕生以来のブロックチェーンの完全なデータセットを復元するためです。
フルノードとライトノードは、履歴データや不要なブロックチェーンデータをプルーニングするため、同期にかかる時間がはるかに短くなります。例えば、フルノードは最新ブロックとその数百ブロック前までしか同期しません(ライトクライアントは最新のブロックヘッダーのみを同期します)。
この同期の遅さは開発プロジェクトを停滞させる可能性があるため、ブロックチェーンノードプロバイダーの利用が推奨されます。ノードプロバイダーを利用すれば、完全に同期済みのアーカイブノードをオンデマンドでデプロイでき、アーカイブノードの運用にかかる負担を軽減できます。
アーカイブノードのサイズはどれくらいか?
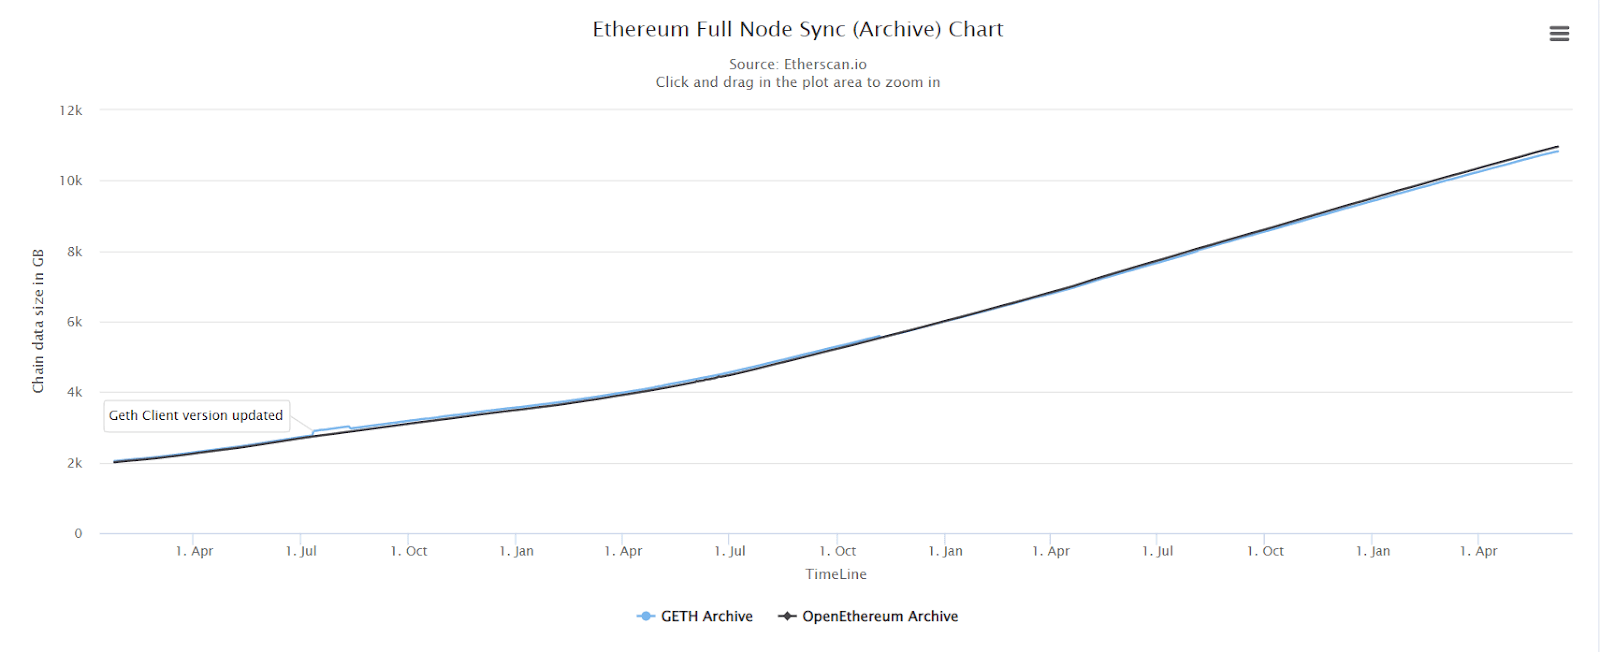
執筆時点で、2つの主要なクライアント(GethとOpenEthereum)を実行するアーカイブノードは10TB以上のデータを保存しています。
参考までに、Gethを実行するフルノードは700GBをわずかに超える程度のブロックチェーンデータしか保存しません。このような差が生じる理由については既に説明した通りです。つまり、アーカイブノードは定期的に古いデータをプルーニングするフルノードとは異なり、ジェネシスからのブロックチェーンデータを復元する必要があるためです。
アーカイブノードを使う理由
アーカイブノードは、ブロックチェーンの過去の情報にアクセスするためのゲートウェイを提供します。これは、直近128ブロック(フルノードで取得可能な範囲)よりも古いデータが必要な場合に役立ちます。
Ethereumアーカイブノードの2つのユースケースを紹介します。
1. ブロックチェーンの履歴情報の監査
ブロックチェーンを監査したり、特定の履歴データを収集したりするサービスを構築する場合、アーカイブノードは最適な選択肢です。良い例としては、ブロックチェーンエクスプローラー(Etherscan)、オンチェーン分析ツール(Dune Analytics)、暗号通貨ウォレットの構築が挙げられます。
これらのサービスは、ユーザー向けに古い状態データを照会・提供するためにアーカイブノードに依存しています。例えば、Etherscanを使ってEthereumで最初にマイニングされたブロックに関する情報を取得できます。同様に、Dune Analyticsでは誕生からのUniswapの総ユーザー数を確認できます。
2. dapp開発
自分のノードを稼働させることは、dAppを構築する際の最低限の要件であることが一般的です。トランザクションの送信、トランザクションのメモリプールの分析、スマートコントラクトのイベントの監視、最近のブロックチェーン情報の呼び出しといった作業だけが必要な場合は、フルノードで十分です。
しかし、フルノードを使って最初の128ブロックを超える情報を呼び出そうとすると、エラーが発生します。フルノードはブロックチェーンデータをプルーニングし、ネットワークの状態を検証するために必要な最小限のデータのみを保持しています。
dAppプロジェクトでは、古いブロックチェーンデータを_迅速に_照会するためにアーカイブノードを稼働させる必要があります。この最後の部分が重要です。なぜなら、フルノードでもアーカイブデータを構築することは可能ですが、より時間がかかるからです。アーカイブノードを使えば、特定のブロック番号におけるアカウントの残高取得といった操作も、スムーズかつ高速に行えます。
アーカイブノードへのアクセスを必要とする可能性があるアプリの例には、以下が含まれます。
- 長期間にわたるユーザーの活動を追跡するオンチェーンレピュテーションサービス(例:DegenScore)
- ユーザーがガバナンス提案について議論・投票できるガバナンスプラットフォーム(例:Tally、Snapshot)
これらのdAppの例やその他の類似事例に共通するのは、過去のオンチェーンデータを参照する必要性です。
アーカイブノードの稼働方法
アーカイブノードの稼働には、ノードクライアントと、フルノードやライトクライアントよりも強力なハードウェアが必要です。
アーカイブノードは、サードパーティのプロバイダーに依存することなく過去の状態データを取得できる点で_有用_です。これにより、特に税務コンプライアンスなど特定の目的でデータが必要な場合、自分の情報を自らコントロールできるようになります。しかし、保存・処理する必要がある膨大な情報量のため、適切なハードウェア要件を満たすことが必須となります。
アーカイブノードクライアントとは?
**アーカイブノードクライアントとは、ローカルで実行できるブロックチェーンの実装のことです。**クライアントは、ノード(アーカイブノードを含む)が他のピアと通信し、ブロックチェーンデータにアクセスすることを可能にします。問題なくEthereumアーカイブノードを稼働させるには、信頼性と性能を備えたノードクライアントが必要です。
人気のアーカイブノードクライアントには何があるか?
最も人気があり信頼されているアーカイブノードクライアントは、Go Ethereum(Geth)、Erigon、Nethermind、Besuです。それぞれをより詳しく見ていくことで、これらのクライアントについて理解を深めることができます。
Gethアーカイブノード
GethはEthereumブロックチェーン向けに開発された最も初期のクライアント実装の一つです。また、Ethereumノードで使用される主要なクライアントでもあります。Gethはユーザー向けに豊富なツールと機能を備えています。Goで書かれており、GNU Lesser Public Licenseの下で公開されています。Gethでアーカイブノードを稼働させる方法についてさらに詳しく見てみましょう。
Erigonアーカイブノード
Erigonは、ノードユーザー向けのもう一つのGoベースのEthereumクライアントです。Erigonは効率的な状態ストレージへのアクセス、より高速な同期時間、Grafanaダッシュボード分析、便利なJSON-RPCデーモンを提供します。Erigonでアーカイブノードを稼働させる方法についてさらに詳しく見てみましょう。
Nethermindアーカイブノード
NethermindはC#の.NETフレームワークを使って構築されたEthereumプロトコルの実装です。Nethermindは利用可能な最速のEthereumクライアントであると謳っており、安定性、セキュリティ、信頼性、データの整合性を提供します。Nethermindでアーカイブノードを稼働させる方法についてさらに詳しく見てみましょう。
Besuアーカイブノード
Hyperledger Besuはエンタープライズユーザー向けに設計されたEthereumクライアントですが、個人ユーザーでも利用可能です。Besuは Javaで書かれており、トレース機能、GraphQL API、充実したモニタリング機能などの有用な機能を提供します。Besuでアーカイブノードを稼働させる方法についてさらに詳しく見てみましょう。
アーカイブノードの稼働にはどのようなハードウェアが必要か?
アーカイブノードは他のタイプのノードよりも多くの読み書き操作を実行し、より多くのRAMとCPUを使用するため、その計算負荷の高い処理を補うために特殊なハードウェアへの投資が求められる場合があります。
以下はEthereumアーカイブノードの稼働に必要な要件のリストです。
オペレーティングシステム:Windows、Linux、またはmacOS
プロセッサ:Intel i7相当以上
ストレージ:少なくとも8〜10TBの容量を持つソリッドステートドライブ(SSD)
RAM:少なくとも16〜32GBのRAMディスク
CPU: 4コア以上のCPU
帯域幅: 25MB/s以上の速度
ノードのハードウェアをセットアップし、クライアントを設定したら、フロントエンドライブラリ(ethers.js/web3.js)とJSON-RPC呼び出しを使ってEthereumブロックチェーンを利用開始できます。例えば、`eth_getBalance`関数を呼び出して、古いアドレスの残高を取得してみることができます。
Alchemyでのアーカイブノードへの無料アクセス
これまで説明してきたように、Ethereumアーカイブノードの稼働には多大な投資が必要です。これには、アーカイブノード自体を管理するために必要な時間と労力は含まれておらず、特に同期が外れてしまった場合はなおさらです。しかし、Alchemyのようなノードプロバイダーが管理するアーカイブノードのエンドポイントに接続することで、これらすべてを省略できます。
AlchemyのNode APIは、アーカイブデータへの無制限のリクエストをサポートし、必要なすべての過去のブロックチェーン情報へのアクセスを提供します。その利点は?アーカイブノードへの接続は_無料_で行えることです。
Alchemyは、無料ティアのユーザーに対しても無制限のアーカイブノードアクセスを提供しています。これは、追加料金を支払うことなく、過去のオンチェーンデータを取得したり、ジェネシスからチェーン全体をフォークすることさえ可能であることを意味します。AlchemyにはPolygonのアーカイブノード、Ethereum、その他多くの人気チェーンへのアクセスが含まれています。

Alchemyでフルアーカイブノードに接続する方法
Alchemyでアーカイブノードに接続する手順は以下の通りです。
-
アカウントにサインアップし(無料です!)、最初のプロジェクトを作成します。
-
Alchemyキーを作成します。これがアーカイブノードに接続するためのURLエンドポイントになります。
-
コマンドラインインターフェースから、過去のデータについてEthereumブロックチェーンへのリクエストの送信を開始します。
まとめ
アーカイブノードは、直近128ブロックを超えて拡張される過去のブロックチェーンの状態を保存できます。dAppやWeb3サービスが過去のブロックチェーンデータへのアクセスを必要とする場合、アーカイブノードを稼働させることは当然の選択です。ただし、完全に機能するアーカイブノードを稼働させることの負担が、開発者を躊躇させ、開発計画を停滞させる可能性がある点には注意が必要です。
AlchemyのNode APIは、無料のURLエンドポイントを使用するアーカイブノードにユーザーを接続することで、この問題を解決します。Alchemyを使えば、Ethereumアーカイブノードの稼働がこれまでになく容易になります!
関連する概要
 インフラ
2026年10月13日
ブロックチェーンインデクサーとは?
ブロックチェーンインデクサーがブロックを読み、リオーグを越え、自前で組むかマネージド API を呼ぶかの判断。
 インフラ
2026年10月13日
Google Cloud Blockchain Node Engineの代替: Alchemyへの移行方法
Google Cloud Blockchain Node Engineは2026年12月15日に終了する。URLを変えるだけでAlchemyに移行でき、コードはそのまま、1つのキーで100以上のチェーンを使える。
 インフラ
2026年9月10日
自律型オンチェーンエージェント構築のための最適なブロックチェーンAPI
自律型オンチェーンエージェント向けの主要ブロックチェーンAPIプロバイダーを比較し、エージェントネイティブな機能、対応チェーン、ユーザーがマシンである場合に重要となる機能性について解説します。

ブロックチェーンで魔法を生み出す
Alchemyは、最も強力なweb3開発者向けプロダクトとツールを、豊富なリソース、コミュニティ、そして卓越したサポートと組み合わせて提供します。