Archive nodes - tudo o que você precisa saber

Escrito por Alchemy
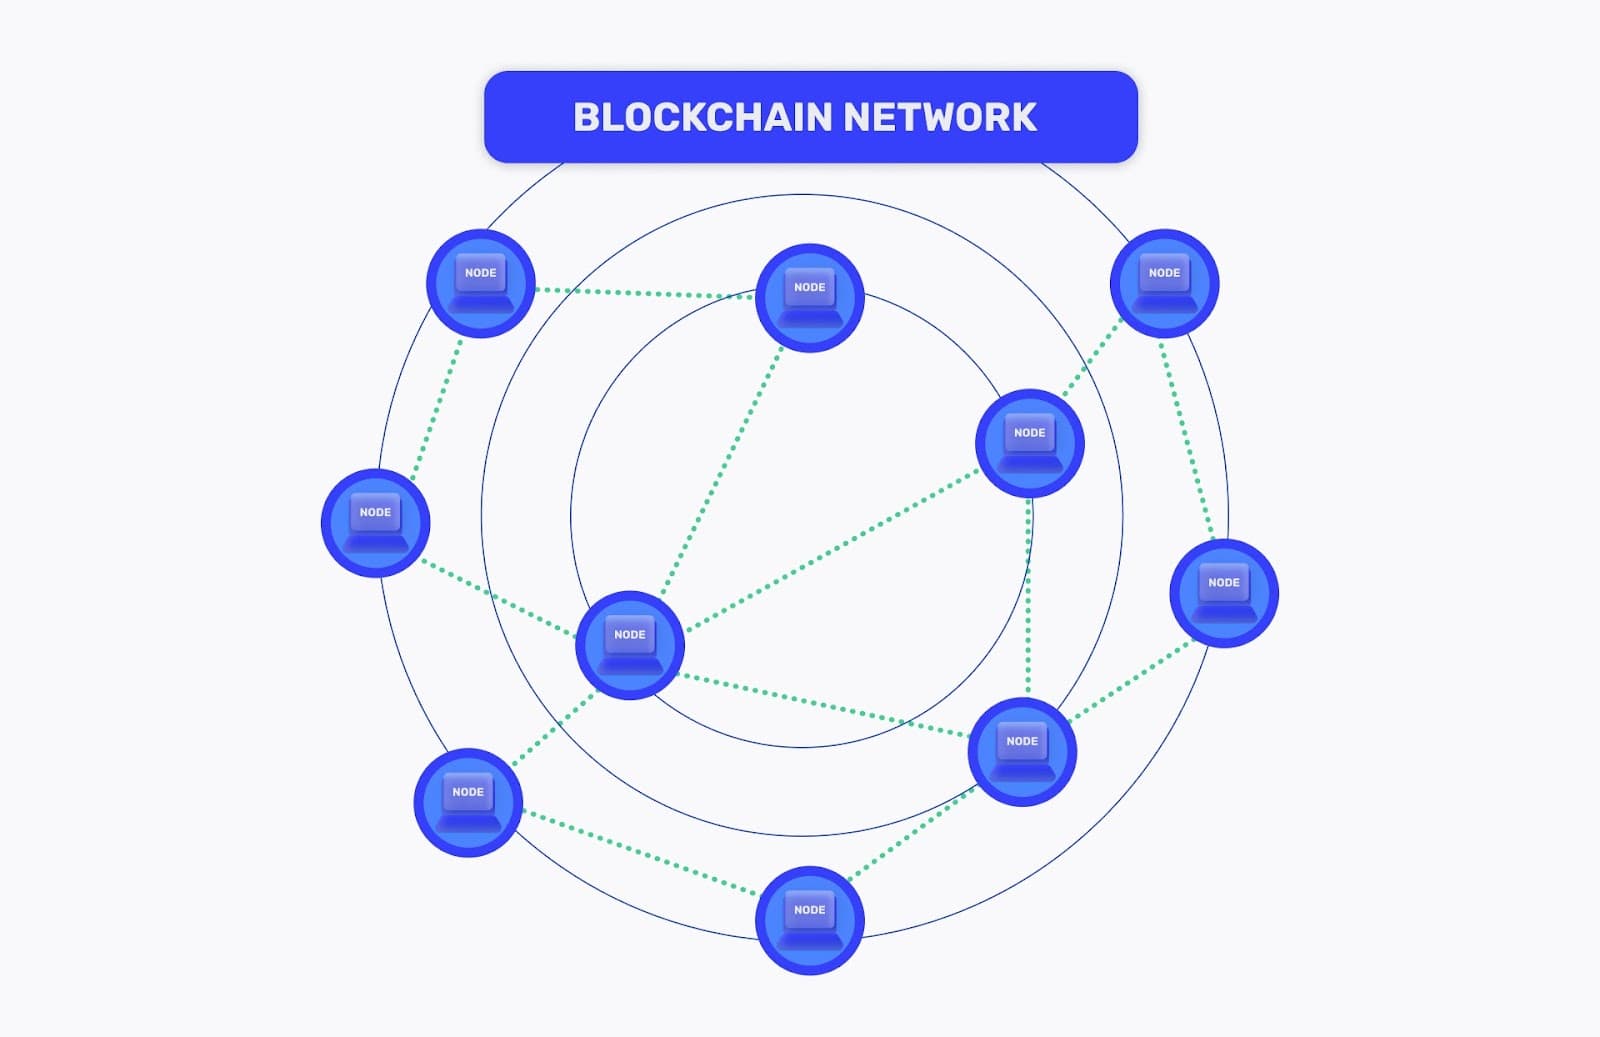
Uma blockchain pública como Ethereum ou Polygon é uma rede global peer-to-peer de computadores. Os nós, como cada dispositivo peer é conhecido, armazenam e processam informações da blockchain e verificam o estado da rede, entre outras coisas.
Embora os nós possam interagir com outros peers na blockchain, eles têm capacidades e casos de uso diferentes. Por exemplo, archive nodes—discutidos neste artigo—podem armazenar o histórico completo de dados da blockchain e servi-lo sob demanda. Isso é diferente dos full nodes, que armazenam apenas o estado recente da blockchain, e dos light nodes, que basicamente solicitam dados de full nodes.
Este overview cobre archive nodes em detalhes e explica como eles funcionam na Ethereum. Você vai aprender por que rodar um archive node importa, quais clients usar, e como construir seu archive node para consultar dados históricos da blockchain.
O que é um archive node da Ethereum?
Um archive node da Ethereum é um full node com capacidade para armazenar todo o histórico da blockchain, até mesmo o genesis block, ou o primeiro bloco já criado. Cobrimos todos os tipos de nós em detalhes no nosso guia sobre blockchain nodes, então aqui daremos apenas uma visão geral rápida de cada tipo:
Full nodes
Full nodes armazenam o estado atual e mais recente da blockchain (até os últimos 128 blocos) e participam da validação de blocos recém-adicionados. Eles podem processar transações, executar smart contracts, e consultar/servir dados da blockchain. Também conseguem acessar alguns dados históricos (via tracing), mas são ineficientes para essa tarefa.
Light nodes (também chamados de “light clients”)
Light clients armazenam apenas block headers, dando acesso a dados mínimos da blockchain (por exemplo, timestamp do bloco, hash, dificuldade de mineração, etc.). No entanto, eles também podem interagir com full nodes para obter os dados necessários e validar informações (por exemplo, verificar o status de uma transação ou consultar saldos). Rodar um light node exige o menor investimento em hardware, custos operacionais e conhecimento técnico.
Archive nodes
Archive nodes armazenam as mesmas informações que os full nodes, além de todos os estados anteriores da blockchain. Rodar um archive node exige o maior investimento em hardware, custos operacionais, conhecimento técnico e experiência. Archive nodes constroem dados históricos da blockchain de forma rápida e eficiente, sendo úteis para consultar dados históricos arbitrários, como o saldo de um usuário em um bloco específico.
Archive nodes exigem mais espaço que outros nós (já que armazenam mais dados), mas o investimento vale a pena em casos específicos. Na próxima seção, exploramos como os archive nodes funcionam e como sua arquitetura difere de outros tipos de nós.
Como os archive nodes funcionam?
Archive nodes armazenam todos os estados históricos de uma blockchain entre blocos. Um archive node contém basicamente snapshots da rede em diferentes pontos no tempo.
Quais dados um archive node sincroniza?
Um archive node executa um "full sync", que baixa os dados completos dos blocos a partir do genesis block, incluindo block headers, transações e receipts.
Como todos os nós, um archive node precisa se "sincronizar" com o estado atual da blockchain para armazenar e verificar dados na rede. A sincronização exige recuperar dados de estado de outros peers, verificar transações e construir uma instância local da blockchain.
Archive nodes verificam todos os blocos baixados, reexecutam todas as transações e escrevem todos os estados intermediários no seu disco. Essa última parte explica por que archive nodes fornecem um "arquivo" do estado da blockchain em diferentes momentos.
Quanto tempo leva para sincronizar um archive node?
A estimativa média para sincronizar um archive node varia, mas espere de um a três meses (ou mais, se o processo tiver problemas).
Archive nodes levam mais tempo para sincronizar do que full nodes ou light clients comuns. Isso acontece simplesmente porque um archive node recupera o conjunto completo de dados da blockchain desde o início.
Full nodes e light nodes exigem muito menos tempo para sincronizar, já que eliminam dados históricos e desnecessários da blockchain. Por exemplo, um full node sincroniza apenas até o último bloco e possivelmente algumas centenas de blocos antes dele (light clients sincronizam apenas os block headers mais recentes).
Essa lentidão na sincronização pode travar projetos de desenvolvimento, e é por isso que usar um provedor de blockchain nodes é recomendável. Node providers permitem que você implante archive nodes totalmente sincronizados sob demanda, poupando o esforço de rodar um archive node.
Qual é o tamanho de um archive node?
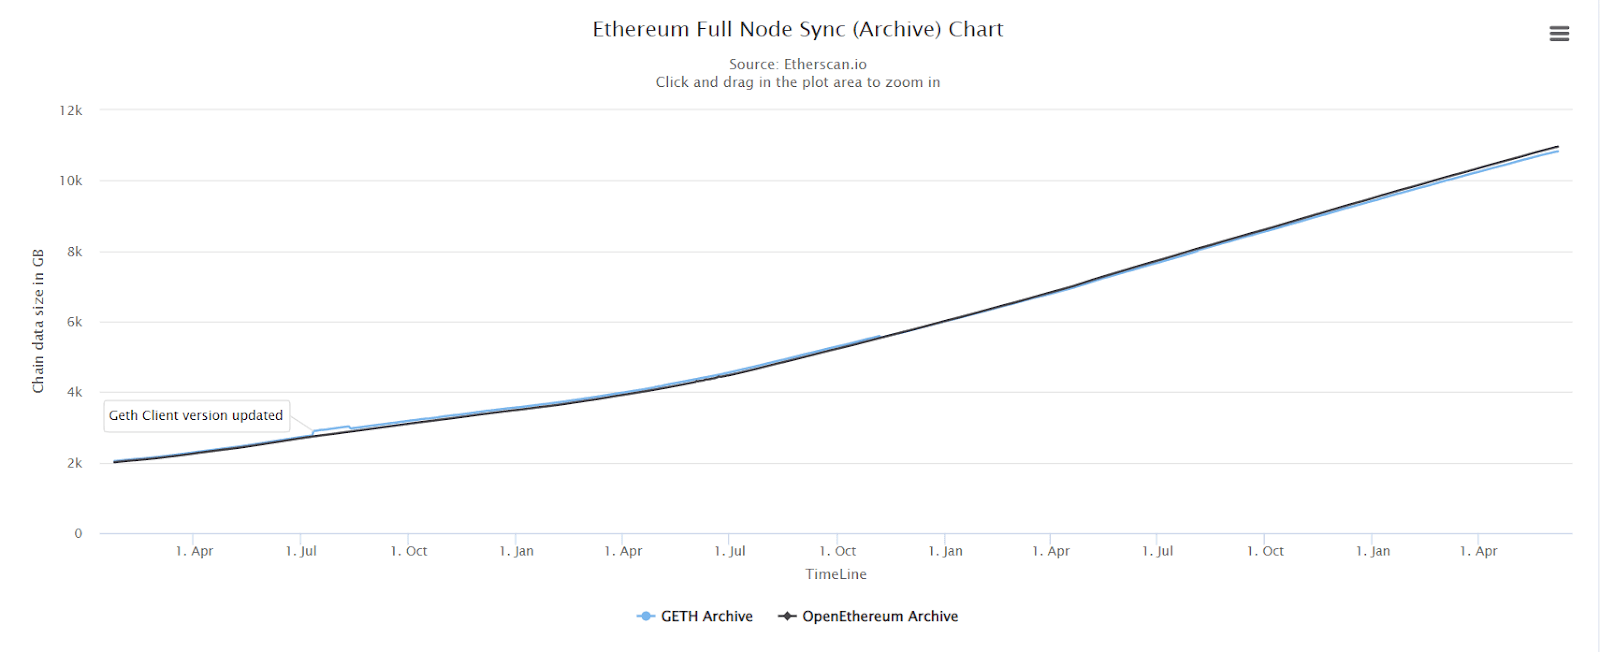
No momento em que este texto foi escrito, archive nodes rodando os dois principais clients (Geth e OpenEthereum) armazenam mais de 10 TB de dados.
Para efeito de comparação, full nodes rodando Geth armazenam pouco mais de 700GB de dados da blockchain. Já explicamos o motivo dessa disparidade—ou seja, a necessidade de recuperar dados da blockchain desde o genesis com archive nodes, ao contrário dos full nodes, que eliminam dados antigos regularmente.
Por que usar archive nodes?
Archive nodes fornecem uma porta de entrada para acessar informações históricas da blockchain. Isso é útil se você precisa de dados mais antigos do que os contidos nos últimos 128 blocos (que estariam disponíveis via full nodes).
Aqui estão dois casos de uso para archive nodes da Ethereum:
1. Auditoria de informações históricas de blockchains
Se você está construindo um serviço para auditar uma blockchain ou coletar dados históricos específicos, um archive node é ideal. Um bom caso de uso seria construir um blockchain explorer (Etherscan), uma ferramenta de análise on-chain (Dune Analytics), ou uma carteira de criptomoedas.
Esses serviços dependem de archive nodes para consultar e servir dados de estado antigos para os usuários. Por exemplo, você pode obter informações sobre o primeiro bloco minerado na Ethereum usando o Etherscan. Da mesma forma, o Dune Analytics pode mostrar o total de usuários do Uniswap desde o início.
2. Desenvolvimento de dapps
Rodar seu próprio nó geralmente é um requisito mínimo para construir um dApp. Um full node é útil se você só precisa fazer coisas como enviar transações, analisar mempools de transações, escutar eventos de smart contracts, e consultar informações recentes da blockchain.
No entanto, tentar obter qualquer informação além dos primeiros 128 blocos usando um full node vai gerar um erro. Full nodes eliminam dados da blockchain e mantêm apenas o mínimo necessário para verificar o estado da rede.
Seu projeto de dApp precisa rodar um archive node para consultar dados antigos da blockchain de forma rápida. Essa última parte é importante porque, embora seja possível construir dados históricos com full nodes, isso leva mais tempo. Com um archive node, operações como obter o saldo de uma conta em determinado número de bloco são rápidas e sem complicações.
Exemplos de apps que podem precisar de acesso a um archive node incluem:
- Serviços de reputação on-chain (por exemplo, DegenScore) que acompanham a atividade do usuário por um longo período.
- Plataformas de governança (por exemplo, Tally, Snapshot) que permitem aos usuários discutir e votar em propostas de governança.
O elo comum entre esses exemplos de dApps e outros semelhantes é a necessidade de examinar dados on-chain históricos.
Como rodar um archive node?
Rodar um archive node exige um node client e hardware mais robusto em comparação com as necessidades de hardware de full nodes ou light clients.
Archive nodes são úteis para recuperar dados históricos de estado sem depender de provedores terceirizados. Eles podem te colocar no controle das suas informações, especialmente se você precisar delas para fins específicos (como conformidade fiscal). Mas, por causa da enorme quantidade de informações que precisam armazenar e manipular, atender aos requisitos de hardware adequados é uma necessidade.
O que é um archive node client?
Um archive node client é uma implementação da blockchain que você pode rodar localmente. Clients permitem que os nós (incluindo archive nodes) interajam com outros peers e acessem dados da blockchain. Para rodar um archive node da Ethereum sem problemas, você precisa de um node client confiável e performático.
Quais são alguns clients populares de archive node?
Os clients de archive node mais populares e confiáveis são Go Ethereum (Geth), Erigon, Nethermind e Besu. Podemos entender melhor esses clients olhando cada um deles com mais detalhes:
Archive node com Geth
Geth é uma das primeiras implementações de client desenvolvidas para a blockchain Ethereum. Também é o principal client usado pelos nós da Ethereum. Geth conta com um grande conjunto de ferramentas e recursos para os usuários. É escrito em Go e está disponível publicamente sob a GNU Lesser Public License. Saiba mais sobre rodar um archive node com Geth.
Archive node com Erigon
Erigon é outro client Ethereum baseado em Go para usuários de nós. O Erigon oferece acesso a armazenamento de estado eficiente, tempos de sincronização mais rápidos, análises via dashboard do Grafana, e um daemon JSON-RPC útil. Saiba mais sobre rodar um archive node com Erigon.
Archive node com Nethermind
Nethermind é uma implementação do protocolo Ethereum construída usando o framework C# .NET. O Nethermind afirma ser o client Ethereum mais rápido disponível e oferece estabilidade, segurança, confiabilidade e integridade de dados. Saiba mais sobre rodar um archive node com Nethermind.
Archive node com Besu
Hyperledger Besu é um client Ethereum projetado para usuários corporativos, embora também funcione para indivíduos. Besu é escrito em Java e oferece recursos úteis, incluindo tracing, GraphQL API, e monitoramento extensivo. Saiba mais sobre rodar um archive node com Besu.
Que hardware você precisa para rodar um archive node?
Como archive nodes realizam mais operações de leitura e escrita e usam mais RAM e CPU do que outros tipos de nós, pode ser necessário investir em hardware especializado para compensar suas exigências computacionais.
Abaixo está uma lista de requisitos para rodar um archive node da Ethereum:
Sistema operacional: Windows, Linux, ou macOS
Processador: Intel i7 ou equivalente
Armazenamento: Solid State Drive (SSD) com pelo menos 8-10 TB de espaço
RAM: RAM disk com pelo menos 16-32GB
CPU: CPU com 4+ núcleos
Banda: Velocidades de 25+ MB/s
Depois de configurar o hardware do seu nó e o client, você pode começar a interagir com a blockchain Ethereum usando bibliotecas frontend (ethers.js/web3.js) e chamadas JSON-RPC. Por exemplo, você pode tentar obter o saldo de um endereço antigo chamando a função `eth_getBalance`.
Acesso gratuito a archive node na Alchemy
Como explicamos, rodar um archive node da Ethereum exige um investimento enorme. Isso sem contar o tempo e a energia necessários para gerenciar o archive node, especialmente se ele sair de sincronia. Mas você pode pular tudo isso conectando-se a um endpoint de archive node gerenciado por um node provider, como a Alchemy.
A Node API da Alchemy suporta requisições ilimitadas para dados de archive e fornece acesso a todas as informações históricas da blockchain que você precisa. A melhor parte? Você pode se conectar a um archive node de graça.
A Alchemy oferece acesso irrestrito a archive nodes mesmo para usuários no tier gratuito. Isso significa que você pode acessar dados on-chain passados e até mesmo fazer fork da chain inteira desde o genesis, sem pagar taxas adicionais. A Alchemy inclui acesso a archive nodes para Polygon, Ethereum, e muitas outras chains populares.

Como se conectar a archive nodes completos na Alchemy?
Aqui está um passo a passo para se conectar a archive nodes com a Alchemy:
-
Crie uma conta (é grátis!) e crie seu primeiro projeto.
-
Crie sua Alchemy key. Este é o endpoint de URL para se conectar ao seu archive node.
-
Comece a enviar requisições a partir da command-line interface para a blockchain Ethereum em busca de dados históricos.
Conclusão
Archive nodes podem armazenar estados passados da blockchain além dos últimos 128 blocos. Se seu dApp ou serviço Web3 precisa acessar dados históricos da blockchain, rodar um archive node é a escolha óbvia. Mas esteja ciente de que as exigências de rodar um archive node totalmente funcional podem desestimular desenvolvedores e travar planos de desenvolvimento.
A Node API da Alchemy resolve esse problema conectando usuários a archive nodes que usam endpoints de URL gratuitos. Com a Alchemy, rodar um archive node da Ethereum nunca foi tão fácil!
Visões gerais relacionadas
 Infra
13 de outubro de 2026
O que é um indexador de blockchain?
Como um indexador de blockchain lê blocos, sobrevive a reorgs e quando construir um em vez de chamar uma API gerenciada.
 Infra
13 de outubro de 2026
Alternativa ao Google Cloud Blockchain Node Engine: como migrar para a Alchemy
O Google Cloud Blockchain Node Engine será desativado em 15 de dezembro de 2026. Migre para a Alchemy trocando uma URL, mantenha seu código e use mais de 100 chains com uma chave.
 Infra
10 de setembro de 2026
As melhores APIs de blockchain para construir agentes onchain autônomos
Uma comparação dos principais provedores de API de blockchain para agentes onchain autônomos, cobrindo recursos agent-native, cobertura de chains e as capacidades que importam quando seu usuário é uma máquina.

Construa magia blockchain
A Alchemy combina os produtos e ferramentas de desenvolvimento Web3 mais poderosos com recursos, comunidade e suporte lendário.