専用ブロックチェーンインフラプロバイダーの評価方法

執筆者 Lisa Ma
専用のブロックチェーンインフラプロバイダーを選ぶことは、その後何年にもわたって影響が続く判断です。重要な判断基準の大半は、営業デモでは見えてきません。本番環境でスケールした後になって初めて表面化します。月額料金が最も安く見えるプロバイダーが、ダウンタイム、古いデータ、エンジニアリング工数という形で最もコストのかかる選択になることもあります。
このガイドでは、契約前に確認すべき質問を、実際に重要な順に並べています。どのプロバイダーに対しても、確実にデプロイしスケールするためのチェックリストとして使ってください。
速度ではなく一貫性から確認する
どのプロバイダーもレイテンシの数値を提示してきます。しかし、ノード間で結果が食い違ったときに何が起こるかを説明できるプロバイダーは、はるかに少数です。
本番環境で最もダメージが大きい障害は、遅さではありません。チェーンの最新状態から遅れたノードが、それに気づかずに古いデータを自信満々に返してくることです。プロバイダーに対して、冗長化されたノード間で読み取りの一貫性をどう保っているか、そして読み取り結果が現在のチェーン状態を反映していることをどう保証するかを尋ねてください。一貫性レイヤーの背後で冗長化されたノードを運用しているプロバイダーは、単一の高速なノードでは解決できない問題に取り組んでいます。
確認すべきこと: ノード間で読み取りの一貫性をどのように保っていますか?あるノードが遅れた場合、自分のリクエストはどうなりますか?
アップタイムと、その裏付け
高いアップタイムを謳うプロバイダーはどこにでもあります。役に立つ質問は、その数値が何を基準に測定されているか、そして実際の負荷イベント時にそれが維持されたかどうかです。
具体的なアップタイムの数値、その測定方法、そして大規模な清算やネットワークアップグレードのような直近の高トラフィック時にどうパフォーマンスしたかを尋ねてください。平時のパフォーマンスは最低条件に過ぎません。スパイク時のパフォーマンスこそが、実際の製品力です。
確認すべきこと: 測定されたアップタイムはどのくらいですか?直近の大規模なネットワーク負荷イベント時にはどうパフォーマンスしましたか?
分離とコンプライアンス
規制対象業種や金融系のチームであれば、シングルテナントの分離こそが、そもそも専用インフラを検討する理由であることが多いはずです。
インフラが本当にシングルテナントかどうか、どのようなコンプライアンス認証を保有しているか(SOC 2 Type IIが一般的な基準です)、そして自社のワークロードが他の顧客のトラフィックから分離されているかを尋ねてください。「専用」というラベルの付いた共有インフラは、本当の分離とは異なります。
確認すべきこと: これはシングルテナントですか?どのようなコンプライアンス認証を保有していますか?
リージョンの配置
レイテンシに敏感なワークロードにとって、インフラが物理的にどこに設置されているかは、ほぼどの要因よりも数値を左右します。
プロバイダーがどのリージョンにデプロイできるか、自社のユーザーや既存のスタックの近くにクラスターを配置できるか、リージョンによってレイテンシがどう変わるかを尋ねてください。単一リージョンに縛られたプロバイダーは、グローバルまたはレイテンシに敏感なアプリケーションには適していません。
確認すべきこと: どのリージョンにデプロイできますか?自社のスタックの近くにインフラを配置できますか?
柔軟性:カスタム実行環境とハードウェア
多くのチームが自前運用を選ぶ理由は、コントロールにあります。カスタムトレーサー、カスタムバイナリ、自社のワークロードに合わせたハードウェアサイジングです。検討に値する専用プロバイダーであれば、こうしたコントロールを維持できます。
カスタムトレーサーやバイナリを実行できるか、ハードウェアが自社のワークロードに合わせてサイジングされているのか、それとも固定のティアに押し込まれるだけなのか、重いアーカイブやトレース系ワークロードがスロットリングされないかを尋ねてください。プロバイダーへの移行によって、自前運用していた理由であるコントロールを手放すことになるなら、それは本当の代替案ではありません。
確認すべきこと: カスタムトレーサーやバイナリを実行できますか?ハードウェアは自社のワークロードに合わせてサイジングされていますか?
サポートと移行パス
どれほど優れたインフラでも、そこへの移行自体が一大プロジェクトになってしまえば意味がありません。移行がどのように進むか、切り替え前に現行環境と並行して稼働できるか、専用キャパシティに問題が発生した場合のフェイルオーバーが用意されているかを尋ねてください。
確認すべきこと: 移行はどのように行われますか?専用キャパシティに障害が発生した場合のフォールバックは何ですか?
簡易評価チェックリスト
- 一貫性: ノード間で読み取りの鮮度はどう保たれていますか?古いデータは本番環境で最も多い障害の原因です。
- アップタイム: 測定されたアップタイムと、負荷時の挙動は?平時ではなくスパイク時こそが本当のテストです。
- 分離: シングルテナントですか?SOC 2 Type IIですか?専用インフラを選ぶ理由そのものであることが多い項目です。
- リージョン: どのリージョンで、自社のスタックとどれだけ近いですか?レイテンシを左右する最大の要因です。
- 柔軟性: カスタムトレーサー、バイナリ、サイジングされたハードウェアはありますか?自前運用で得ていたコントロールを維持できます。
- サポート: 移行パスとフェイルオーバーは?移行が困難であれば、そのメリットは相殺されます。
弊社のDedicated Clustersは、これらの基準の多くを軸に構築されています:シングルテナントの分離、ブロック単位で正確な一貫性、カスタム実行環境、そして共有フリートへの自動フェイルオーバーです。このガイドの正しい使い方は、弊社を含むすべてのプロバイダーを、同じ質問に照らして評価することです。
はじめに
専用インフラの検討を進める際は、このチェックリストから始め、Node RPC vs. Dedicated Clustersと比較してください。自社のワークロードに合った選択肢について相談する準備ができたら、弊社チームにお問い合わせください。
よくある質問
専用のブロックチェーンインフラプロバイダーで確認すべき点は何ですか?
影響度の高い順に挙げると:ノード間の読み取り一貫性、負荷時に実証されたアップタイム、本当のシングルテナント分離とコンプライアンス、ユーザーに近いリージョン配置、カスタム実行環境とハードウェアの柔軟性、そしてフェイルオーバーを備えたリスクの低い移行パスです。
高性能なRPCノードプロバイダーの条件とは何ですか?
冗長化されたノード間での一貫した読み取り、ユーザーの所在地で測定した低いリージョンレイテンシ、負荷時の低いエラー率、そして通常時だけでなくトラフィックスパイク時にも維持される余裕です。
RPCノードプロバイダーが信頼できるかどうかはどう判断しますか?
測定されたアップタイムの数値とその算出方法、直近のネットワーク負荷イベント時のパフォーマンスの証拠、そしてそのエンドポイントの背後にある冗長性とフェイルオーバーの構成を確認してください。
専用インフラは常に共有インフラより優れていますか?
いいえ。ワークロードが弾力性のある共有プランで問題なく動くのであれば、それが通常はより良く、より経済的な選択です。専用インフラが価値を持つのは、カスタム実行環境、シングルテナントの分離、他では得られないリージョン、持続的な大量トラフィックといった、具体的かつ持続的な理由がある場合です。
関連する概要
 インフラ
2026年3月30日
Node RPC vs. Dedicated Clusters: ワークロードに合ったインフラの選び方
Alchemyの2つのインフラモデルの仕組み、それぞれが適するケース、チームに合った選び方を解説します。
 インフラ
2026年6月15日
専用ブロックチェーンインフラの仕組み
専用ブロックチェーンインフラは、RPCとインデックス処理のワークロードをシングルテナントクラスタ上に配置します。分離、リージョン、冗長性、フェイルオーバーの仕組みを解説します。
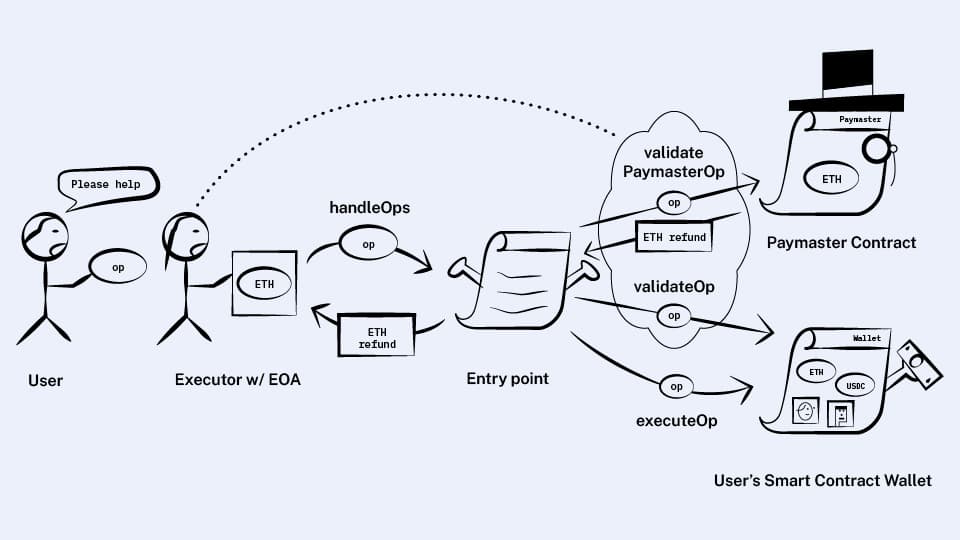 ウォレット
2026年10月14日
ペイマスターとは?
ペイマスターはユーザーオペレーションのガスを肩代わりするか、その手数料をERC-20トークンで払わせる。

ブロックチェーンで魔法を生み出す
Alchemyは、最も強力なweb3開発者向けプロダクトとツールを、豊富なリソース、コミュニティ、そして卓越したサポートと組み合わせて提供します。