El router Cortex: cómo elegimos el nodo más rápido y saludable para cada solicitud
Autor: Uttam Singh
Cada llamada RPC que hace tu aplicación tiene que llegar a un nodo y volver antes de que tu usuario vea algo. Lograr que esa llamada llegue a una región cercana es algo que todo proveedor serio hace automáticamente, nosotros incluidos, y seguimos abriendo regiones para acortar aún más ese primer salto. La pregunta más interesante es qué pasa después de que llega: qué nodo específico de esa región responde, y si algo verificó que ese nodo estaba sano y actualizado con la cadena antes de enviarle la solicitud.
Esa segunda decisión es la que tomamos de nuevo en cada solicitud, y es gran parte de la razón por la que nuestro tiempo de respuesta promedio en cadenas EVM es menor a 15ms. Esa cifra es el tiempo de solicitud y respuesta en caliente, medido sobre una conexión que ya está abierta, que es como se ve el tráfico repetido de una aplicación en ejecución. No incluye DNS, el establecimiento de la conexión ni el handshake de TLS, así que el trabajo en el edge descrito más abajo queda fuera de esa cifra, no dentro de ella.
¿Qué decide exactamente el router de Cortex?
Cortex es el motor que impulsa toda la plataforma de Alchemy, desde la flota de nodos hasta la capa de enrutamiento y las APIs de RPC y Data por encima. La configuración anterior ponía un CDN de terceros frente al tráfico, lo que convertía a ese CDN en un punto único de falla para cada red y cada cliente a la vez. Reemplazarlo por bare metal que operamos nosotros mismos eliminó esa dependencia y puso toda la ruta bajo nuestra propia operación. Cada solicitud que envías ahora pasa por Cortex, y el router es la parte que decide a dónde va.
Para cada solicitud, el router elige la ruta: qué región la acepta, qué nodo la atiende, y qué pasa si ese nodo se degrada a mitad del proceso. "La mejor ruta a tu cadena" en realidad significa el nodo sano con menor latencia que pueda responder correctamente esta llamada en particular, en este momento. Esa respuesta cambia segundo a segundo según cambian la carga y el estado de salud, por eso la recalculamos por solicitud en lugar de resolverla una vez y reutilizar el resultado.
La mitad regional de esto ya es estándar en la industria. Una solicitud desde Singapur y otra desde Fráncfort entrarán en lugares distintos en cualquier proveedor importante, y ninguno te obliga a configurarlo. Lo que nosotros agregamos es la segunda decisión, tomada por solicitud y no por conexión: de los nodos disponibles en la región donde llegó una solicitud, cuál está sano, actualizado, y es adecuado para esta llamada en particular.
¿Cómo llega una solicitud a la región correcta?
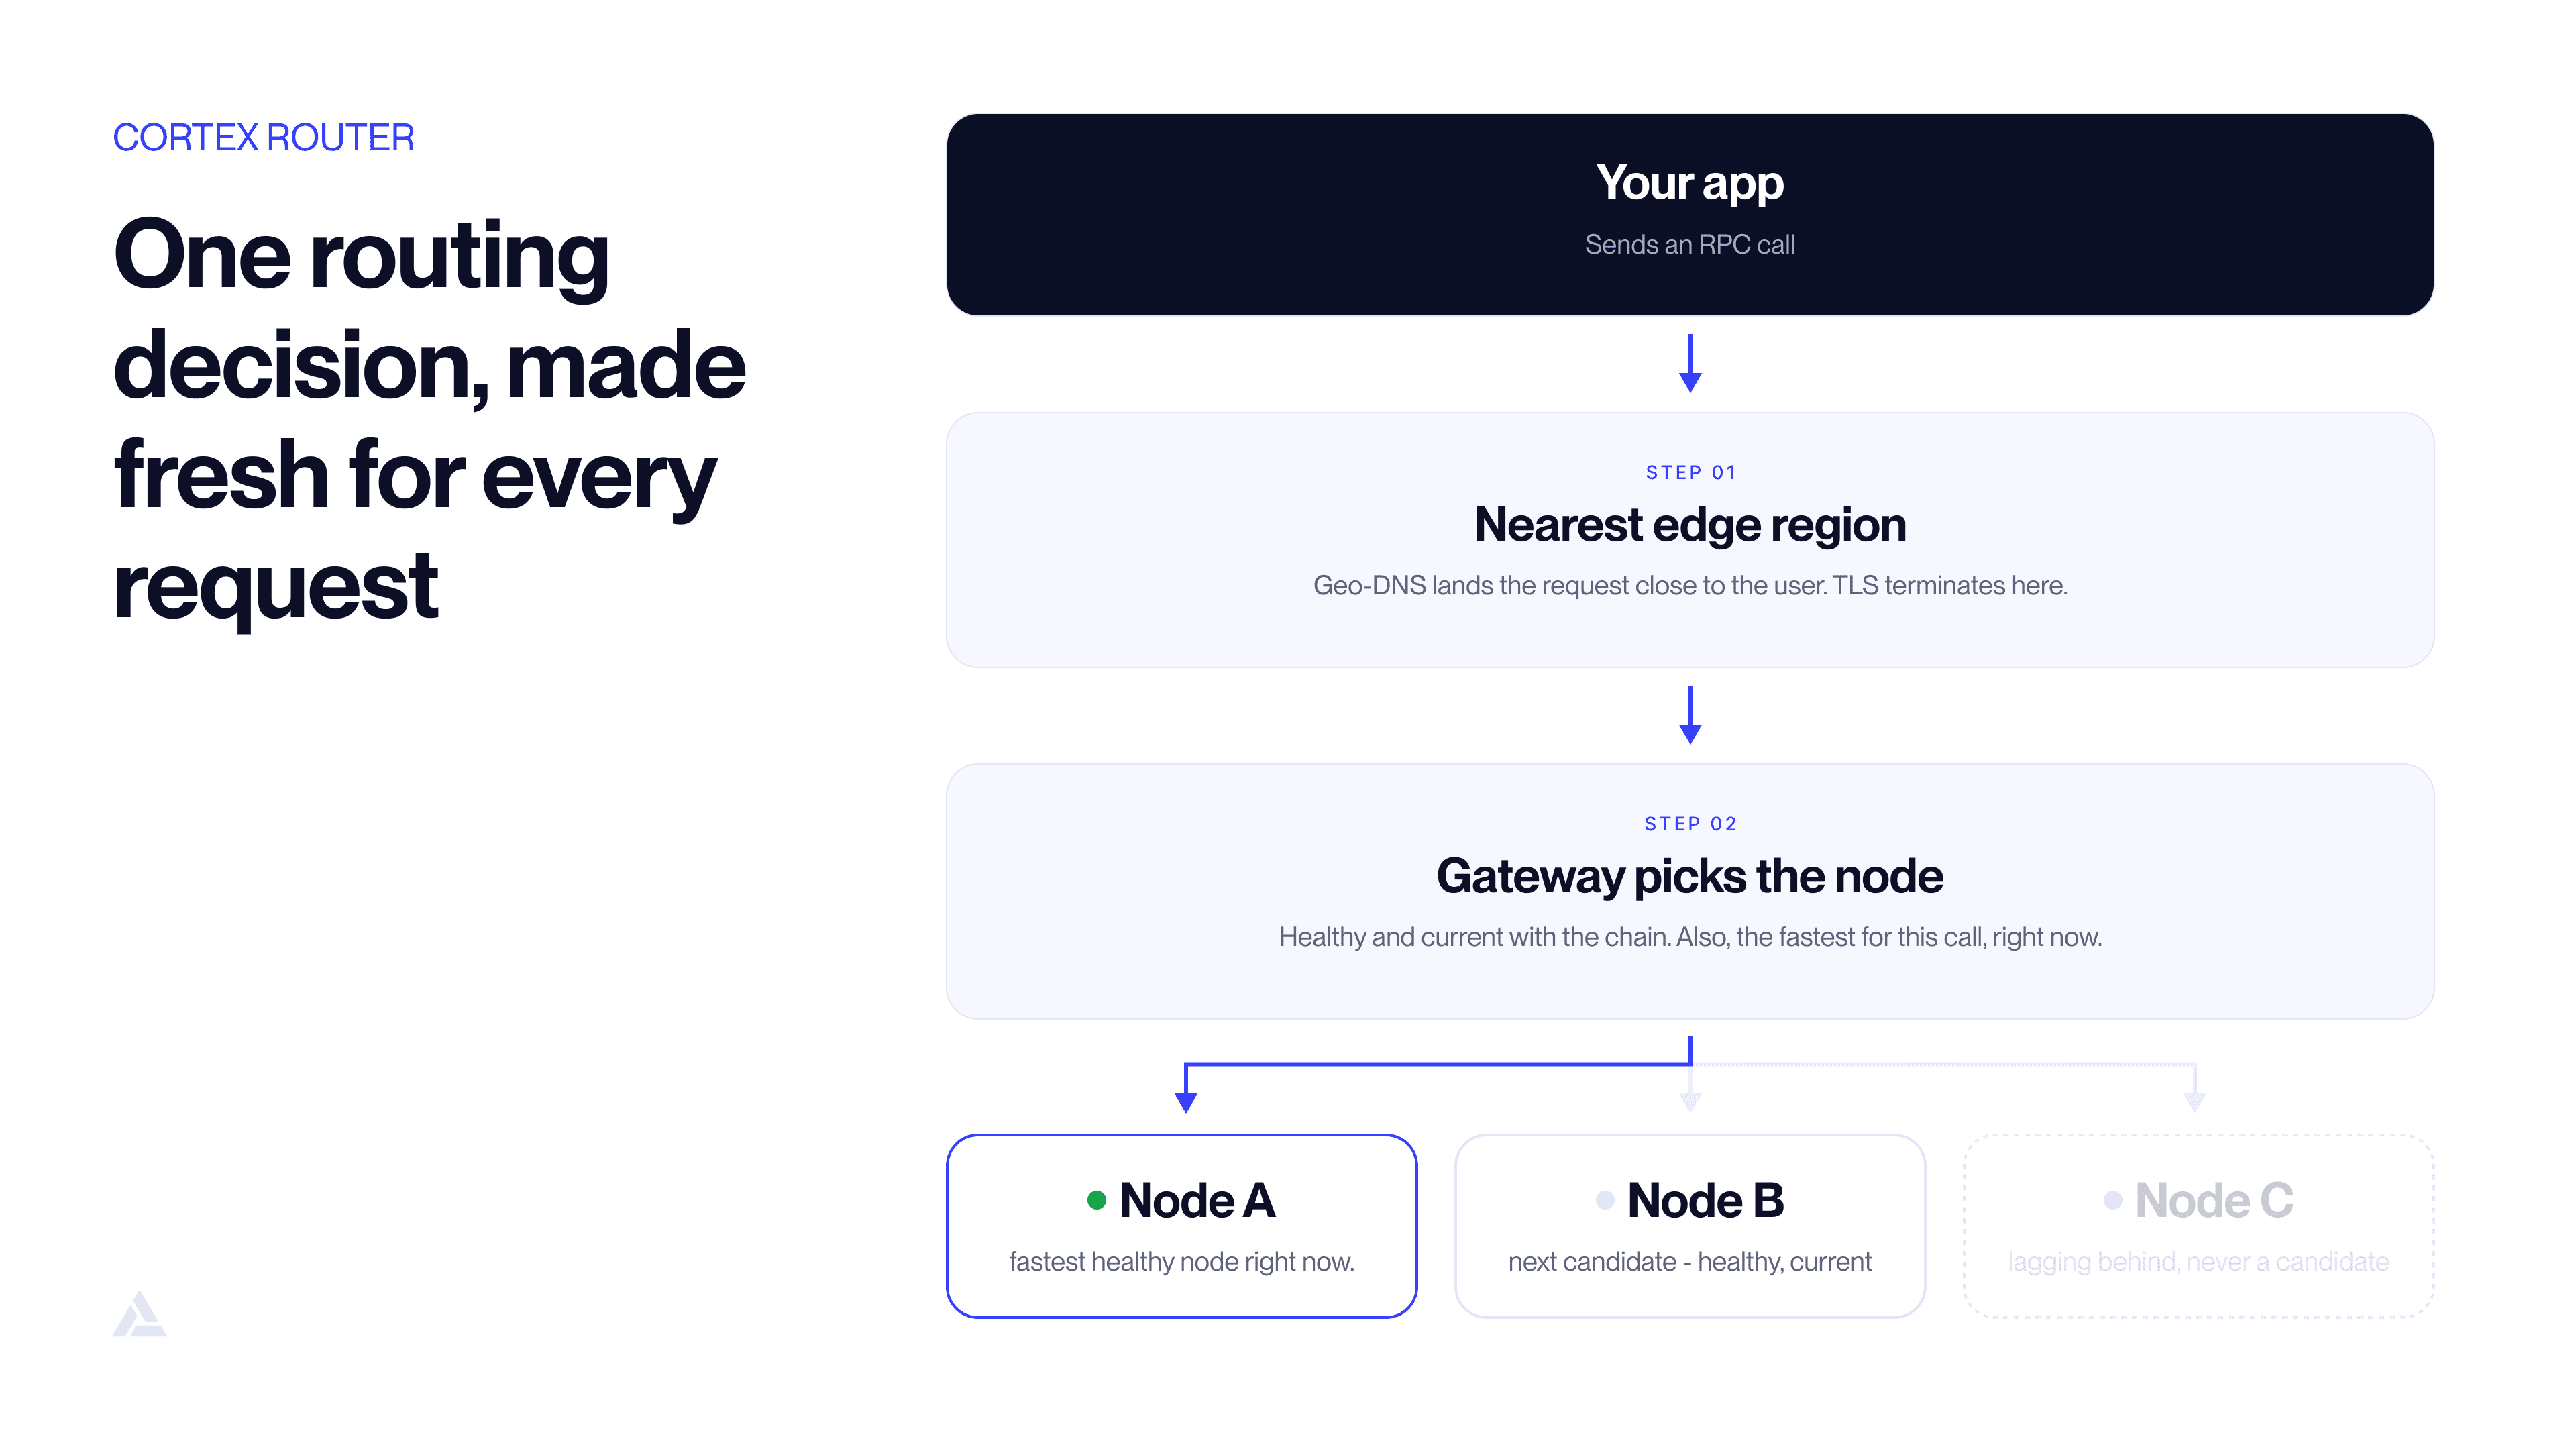
El DNS basado en geolocalización resuelve el endpoint a la región de edge más cercana, así que una solicitud entra al sistema cerca de donde se origina en lugar de que todo el tráfico llegue a un solo lugar. Esto ocurre antes de que el router siquiera considere un solo nodo, porque la distancia hasta la puerta de entrada es tiempo de ida y vuelta puro que nunca se puede recuperar. El establecimiento de la conexión y la negociación TLS también ocurren ahí, en el punto más cercano en lugar de más adentro en la pila.
Esa puerta de entrada es nuestro propio Alchemy Edge Proxy, una capa de ingreso en bare metal que operamos en lugar de un CDN de terceros. Implementarlo fue una de las mayores mejoras de latencia de la reconstrucción. El P99 en Asia-Pacífico pasó de 150ms a 20ms, y el P95 en todas las redes se redujo aproximadamente a la mitad, de unos 200ms a unos 100ms. Esos son el antes y el después de esa migración, no dónde están las cifras hoy, y P95 y P99 son el 5% y el 1% de solicitudes más lentas, que es la parte que los usuarios realmente sienten. El edge es una capa de un esfuerzo más amplio en latencia que va desde el escalado predictivo hasta la automatización de la flota.
¿Cómo elegimos el nodo dentro de una región?
Aquí dos capas hacen trabajos distintos. En el edge, el plano de control revisa qué stacks de servicio soportan la red que pediste y cuáles de esos están sanos, y luego envía la solicitud al más cercano. Pero elegir un nodo ocurre una capa más adentro, en el gateway frente a la flota. Ese gateway es lo primero en la ruta que sabe algo sobre máquinas individuales.
Elegir bien un nodo requiere más que elegir uno cercano, así que varias cosas reducen la lista de candidatos antes de que se reenvíe algo.
- Salud, a partir de seguimiento en vivo. Un sistema de seguimiento de nodos ejecuta verificaciones de salud continuas, y un nodo que las falla no es candidato. Esto es lo que evita que un backend degradado sea elegido en primer lugar, en lugar de que tus usuarios lo descubran.
- Coincidencia sobre el estado actual. No todos los nodos están en el mismo bloque, así que enviar una lectura a cualquiera que responda más rápido puede devolver un estado que la cadena ya superó. Una capa de consistencia mantiene las solicitudes en la misma vista canónica de la cadena sin importar qué nodo las atienda, y las actualizaciones versionadas hacen que no obtengas una lectura desactualizada incluso mientras un failover está en curso.
- Latencia observada, no solo geografía. Los candidatos se puntúan con un promedio móvil ponderado exponencialmente de su latencia medida reciente, el mismo enfoque que los balanceadores de carga han usado durante años. Como las muestras antiguas pierden peso en el promedio, un nodo que empezó a ralentizarse hace minutos cae en el ranking por sí solo, sin que nadie levante una alerta.
- Forma de la carga de trabajo. Los clientes de nodo difieren en su comportamiento de sincronización y en qué métodos atienden bien, y los nodos de archivo y los full nodes guardan datos distintos, así que el método y los parámetros de la solicitud reducen más el conjunto. Una consulta histórica pesada y una simple lectura de balance no pertenecen al mismo nodo.
Así que "menor latencia" nunca es un ajuste que se activa en algún lugar. Se recalcula para cada llamada, a partir de dónde entró esa llamada, qué pide, y qué máquinas resultan estar rápidas y sanas en ese momento.
¿Qué pasa cuando el nodo elegido no está sano?
El failover es parte de la decisión de enrutamiento en lugar de una alarma añadida al costado. Cuando un nodo cae, Cortex redirige el tráfico automáticamente a nodos sanos. El caso más interesante es el nodo que no ha fallado del todo pero está congestionado, atrasado, o corriendo una versión de cliente con un bug conocido, y el mismo enrutamiento consciente del contexto también evita esos casos. Tu aplicación no ve un error, y no hay lógica de reintento que tengas que escribir.
Lo mismo aplica un nivel más arriba. Si una región entera se degrada, las solicitudes se enrutan a una secundaria, y hay un respaldo adicional detrás de esa. La replicación global en tiempo real mantiene cada región consistente durante esas transiciones, así que terminar en una región más lejana no significa leer datos más antiguos.
El shuffle sharding y los pools de nodos redundantes están por debajo de todo esto, manteniendo las fallas aisladas y contenidas en lugar de dejar que un problema se propague por toda la flota. La capa de enrutamiento trata un nodo degradado como una ruta a evitar, que es la misma tolerancia a fallas detrás de nuestro streaming gRPC de Solana sin downtime y de la flota que se mantuvo activa durante el mayor evento de liquidación en cripto.
¿Por qué ser dueños del edge hace más inteligente el enrutamiento?
El tráfico RPC es en su mayoría dinámico. Un eth_call o el envío de una transacción no se pueden cachear como una imagen estática, así que el truco principal de un CDN genérico, servir contenido cacheado cerca del usuario, mayormente no aplica, y la solicitud igual tiene que llegar a un nodo activo. Ser dueños del edge en lugar de alquilar un CDN nos permite afinarlo para esta forma de tráfico específica, y permite que el enrutamiento use señales que una capa de terceros nunca ve, como qué nodo está sincronizado, sano, y es el más rápido para este método y esta cadena ahora mismo.
También significa que no compartimos esa capa con tráfico ajeno. En un CDN compartido, un incidente que no tiene nada que ver con tu aplicación puede igualmente manifestarse como un pico de latencia para ti, y la solución depende del cronograma de otro.
Donde los proveedores realmente se diferencian es todo lo que está por debajo de la región, porque ahí es donde una capa de enrutamiento o bien sabe qué está haciendo cada máquina, o está adivinando.
Lo operamos nosotros mismos porque es la única forma de que ningún tramo de la ruta le pertenezca a alguien más. Pagamos un costo de ingeniería real por eso, y a cambio podemos afinar toda la ruta en lugar de abrir un ticket con quien sea que opere la parte lenta.
¿Qué significa esto para una cadena como Base?
Base es una buena prueba de estrés, porque la cadena en sí es rápida. Publica actualizaciones incrementales de bloque de 200ms mediante Flashblocks, así que una ruta RPC que tarde más que eso en responder se convierte en el cuello de botella en lugar de la cadena. Una llamada a Base desde cualquier región entra por el edge más cercano, se empareja con un nodo de Base sano y actualizado con la cadena, y se redirige dentro de la región si ese nodo se degrada. Eliminar cien milisegundos de sobrecarga de red importa más, no menos, cuando la cadena previsualiza nuevo estado cada 200ms.
La consistencia es la garantía más difícil, y es la que vale la pena usar para juzgarnos. Polymarket es el caso de estrés. Durante las elecciones de EE. UU. de 2024 manejaron más de 125,000 usuarios concurrentes y $3.3 mil millones en apuestas, con solicitudes redirigidas dinámicamente según la latencia p99 para mantener el rendimiento. Sus flujos críticos de ingesta se aceleraron por separado 2.5x, de unos 250ms a unos 100ms. Una mediana medida en una región en una tarde tranquila no dice casi nada sobre lo que obtienen tus usuarios durante un mint o una cascada de liquidaciones. Si prefieres comprobarlo en lugar de tomar nuestra palabra, nuestra metodología de benchmarking mide latencia junto con tasa de éxito y solicitudes fallidas, y los benchmarks de proveedores son públicos.
Construye sobre la misma ruta de enrutamiento
Cada aplicación en Alchemy ya se enruta a través de este motor, sin nada que configurar. Crea un endpoint RPC gratuito y tus lecturas y escrituras siguen la misma ruta por solicitud descrita aquí. Sin contrato, sin lista de espera, sin cambio de endpoint. Tus llamadas a Data API también corren sobre esto.
Si necesitas un nodo fijado a una región, aislamiento single-tenant, o un binario personalizado en la ruta, Alchemy Dedicated Clusters ejecutan el mismo enrutamiento sobre hardware single-tenant, y puedes optar por failover automático hacia la flota compartida si el tráfico supera la capacidad del cluster. De cualquier forma, la solicitud detrás de tu aplicación es la parte en la que dejas de pensar.
Preguntas frecuentes
¿Qué proveedor de RPC ofrece la menor latencia en regiones globales?
El tiempo de respuesta promedio de Alchemy en cadenas EVM es menor a 15ms según nuestros benchmarks actualizados continuamente, medido como tiempo de solicitud y respuesta en caliente sobre una conexión ya abierta. Esa página se recalcula cada pocos minutos, así que lee el ranking de proveedores actual directamente ahí. El uptime es de 99.995%. Todo proveedor serio te enruta a una región cercana. Cortex va más allá dentro de esa región, emparejando cada solicitud con un nodo verificado por su salud y por su coincidencia con el estado actual de la cadena.
¿Qué proveedor de RPC soporta Base RPC con la menor latencia?
Base RPC en Alchemy entra por la región de edge más cercana, y luego se empareja con un nodo de Base sano y actualizado con la cadena. Esto importa más en Base que en cadenas más lentas, porque Flashblocks publica actualizaciones de bloque cada 200ms, así que un nodo incluso ligeramente atrasado puede devolver un estado que ya cambió.
¿Cómo elige Cortex qué nodo atiende una solicitud RPC?
Dos capas comparten el trabajo. El plano de control del edge elige el stack de servicio sano más cercano que soporte la red solicitada, y el gateway frente a la flota luego elige el nodo, reduciendo los candidatos por salud, coincidencia con el estado actual de la cadena, latencia observada recientemente, y el método que se está llamando.
¿El enrutamiento por solicitud agrega latencia?
El enrutamiento es una porción pequeña del presupuesto de respuesta, no la cifra principal. La cifra de menos de 15ms es el tiempo de solicitud y respuesta en caliente en cadenas EVM, no el costo de la decisión de enrutamiento en sí, y no es la misma medición que el promedio de toda la plataforma de menos de 50ms en todas las cadenas y productos. La selección de región ocurre en el edge, cerca del usuario, y la selección de nodo ocurre más adentro, en el gateway frente a la flota.
¿Qué pasa cuando falla un nodo de RPC?
El failover es parte de la decisión de enrutamiento en lugar de un reintento que tengas que construir tú mismo. Cortex redirige el tráfico automáticamente a nodos sanos cuando uno cae, y su enrutamiento consciente del contexto también evita nodos que están congestionados, atrasados, o corriendo un cliente con bugs. Si una región entera se degrada, las solicitudes se mueven a una región secundaria, con replicación en tiempo real manteniendo los datos consistentes.
Boletín de Alchemy
Entérate primero de los lanzamientos
Suscríbete a nuestro boletín
Recibe las últimas actualizaciones de productos y recursos de Alchemy
Al ingresar tu correo electrónico, aceptas recibir nuestras comunicaciones de marketing y actualizaciones de productos. Reconoces que Alchemy procesa la información que recibimos de acuerdo con nuestro Aviso de Privacidad. Puedes cancelar tu suscripción en cualquier momento.

Artículos relacionados

Por qué los equipos de trading eligen Alchemy para RPC de baja latencia
Los equipos de trading eligen Alchemy por lecturas y escrituras de baja latencia cuando el mercado se mueve, y un registro confiable cuando el dinero se liquida, incluso en el volumen pico.

¿Con qué proveedor de RPC deberías construir en Tokio?
Comparamos cinco de los proveedores de RPC que sirven Tokio en cinco cadenas. Así se comparan, y dónde importan las diferencias para los equipos sensibles a la latencia.

Diseño de lecturas RPC de Solana para velocidad y confiabilidad líderes en la industria
Alchemy tiene la latencia de lectura de Solana más baja: 9.21 ms, cerca de 26% más rápido que el siguiente proveedor.