O roteador Cortex: como escolhemos o nó saudável mais rápido para cada requisição
Autor: Uttam Singh
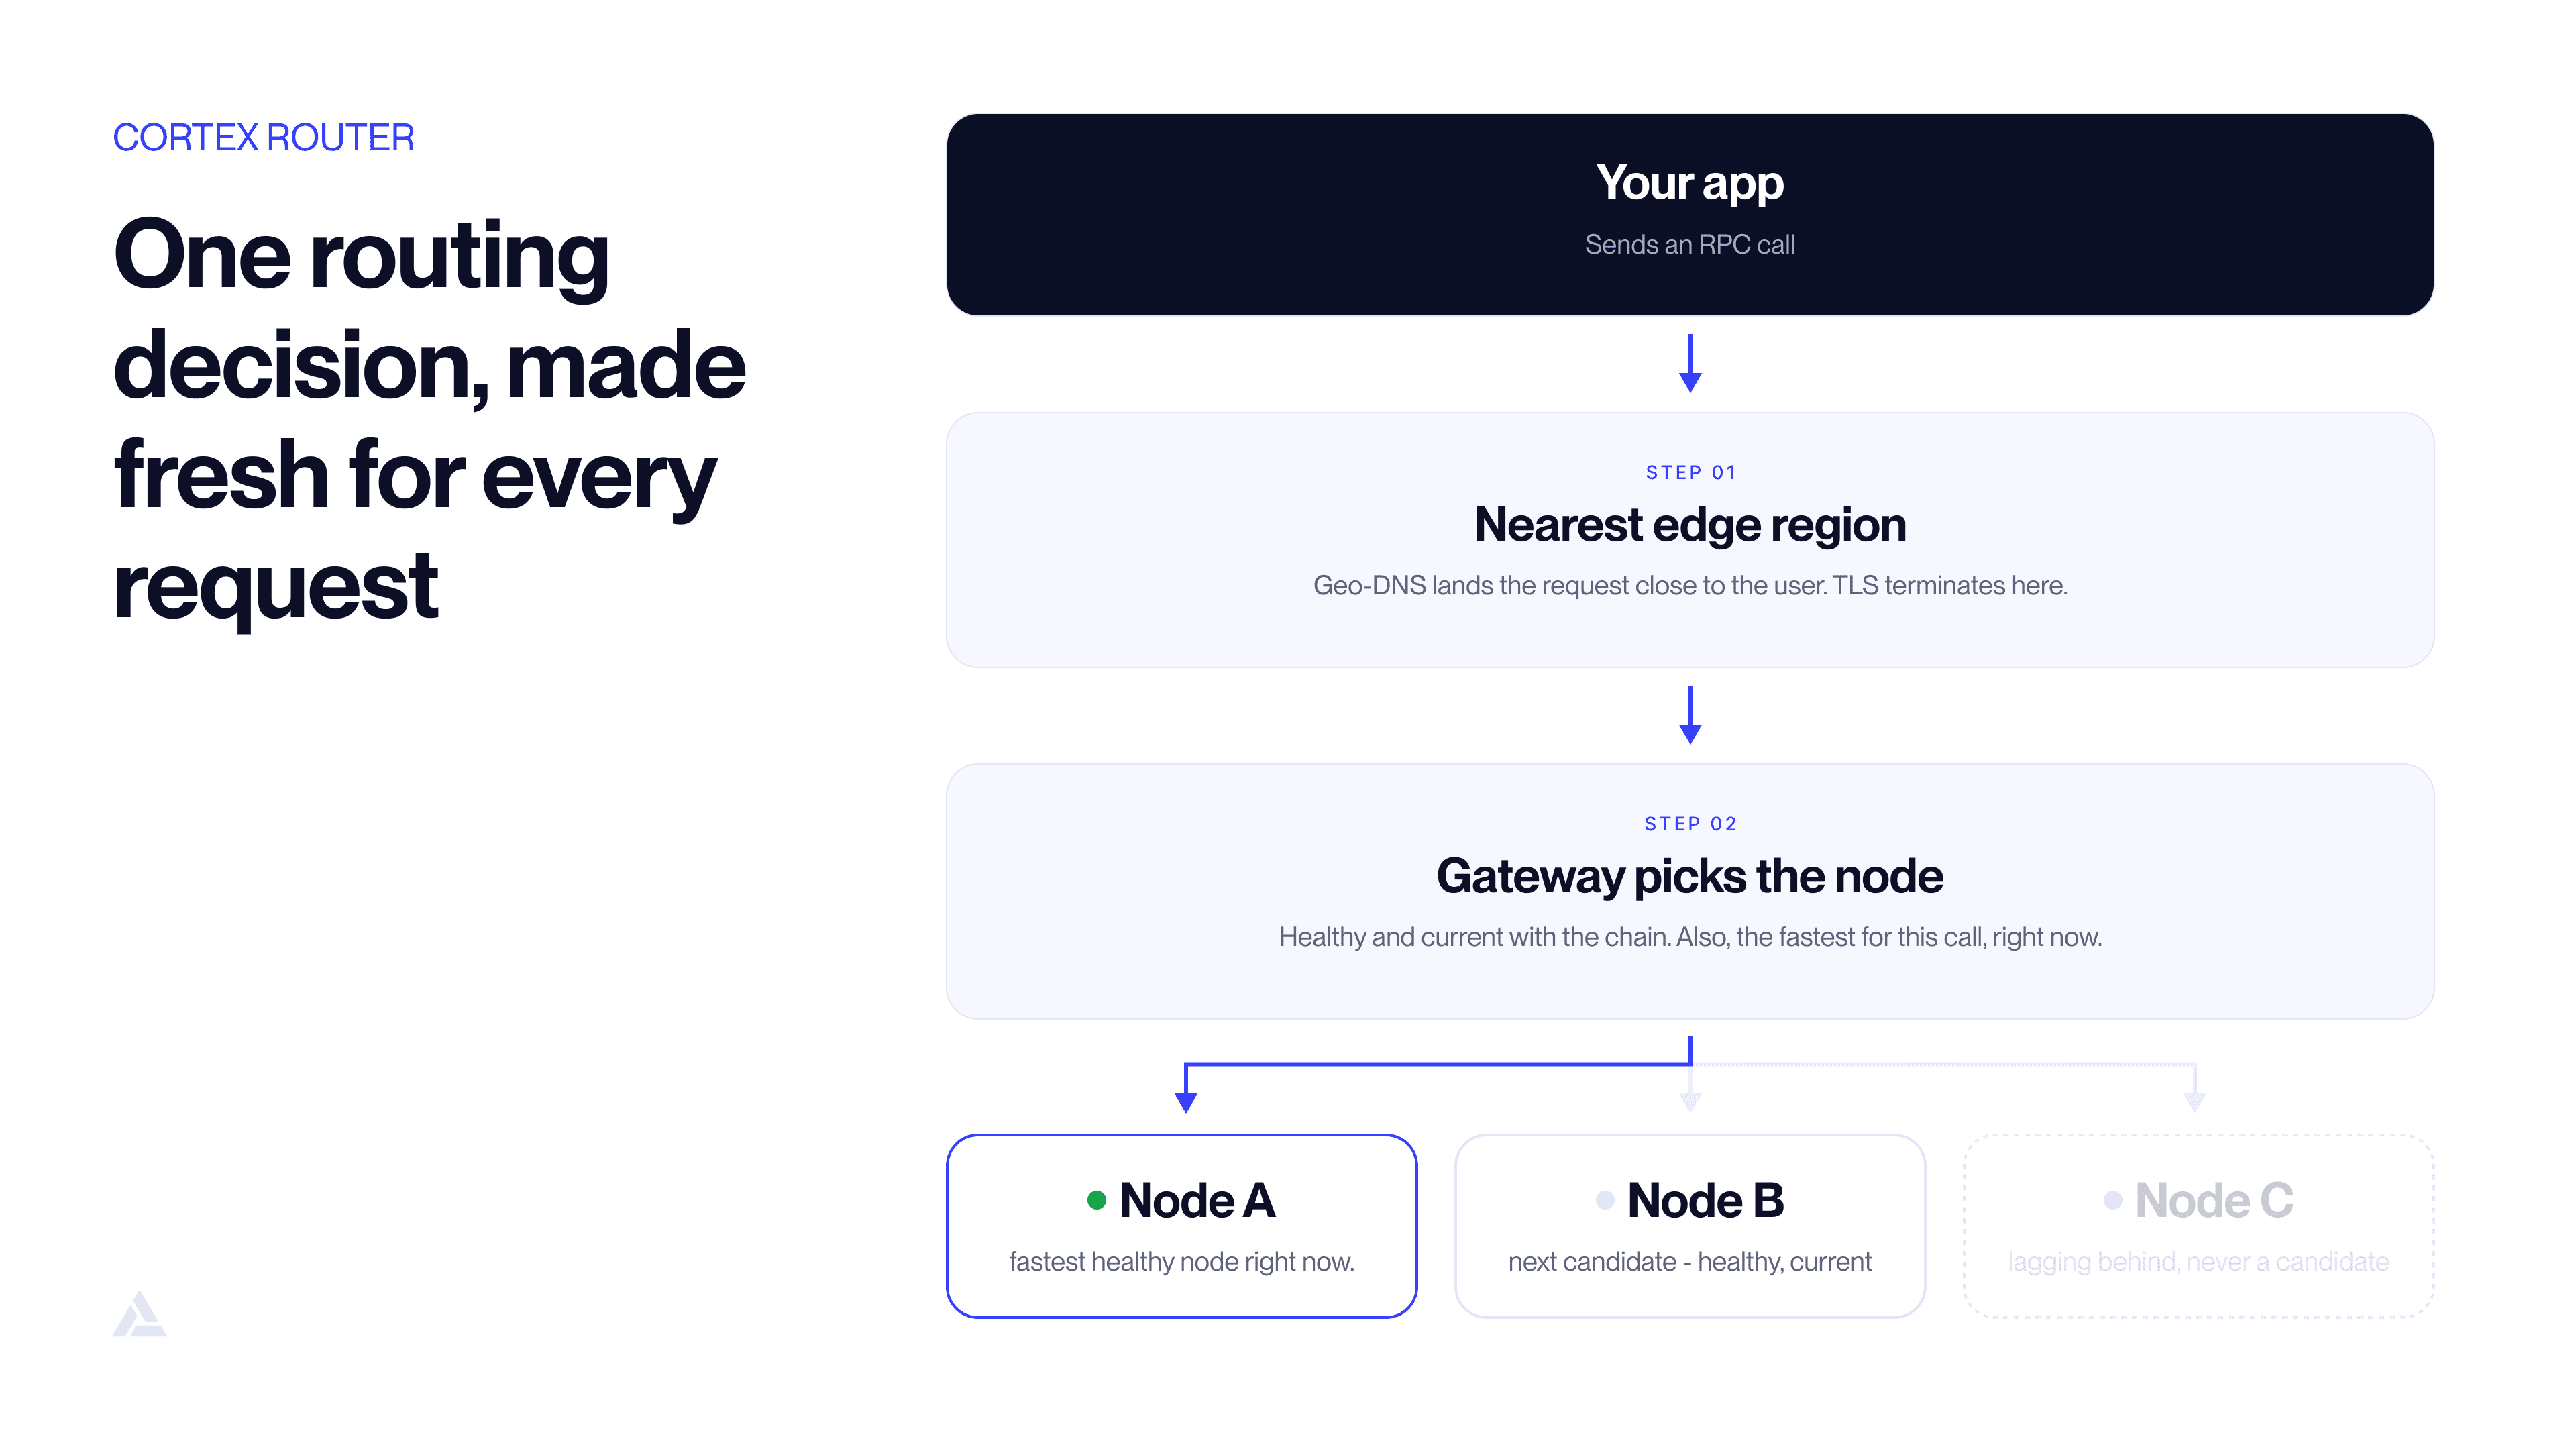
Toda chamada RPC que seu app faz precisa chegar a um node e voltar antes que seu usuário veja qualquer coisa. Levar essa chamada a uma região próxima é algo que todo provedor sério faz automaticamente, nós incluídos, e continuamos abrindo regiões para encurtar ainda mais esse primeiro salto. A questão mais interessante é o que acontece depois que a chamada chega: qual node específico daquela região responde, e se algo verificou que esse node estava saudável e atualizado com a chain antes de a requisição ser enviada até ele.
Essa segunda decisão é a que tomamos do zero a cada requisição, e é grande parte do motivo pelo qual nosso tempo médio de resposta entre chains EVM é abaixo de 15ms. Esse número é o tempo de requisição-e-resposta "quente", medido sobre uma conexão já aberta, que é o que o tráfego recorrente de um app em produção se parece. Ele exclui DNS, estabelecimento de conexão e o handshake TLS, então o trabalho de borda descrito abaixo fica fora desse número, não dentro dele.
O que o roteador Cortex decide, de fato?
Cortex é o motor que alimenta toda a plataforma Alchemy, desde a frota de nodes até a camada de roteamento e as APIs de RPC e Data por cima. A configuração anterior colocava uma CDN de terceiros na frente do tráfego, o que tornava essa CDN um ponto único de falha para todas as networks e todos os clientes ao mesmo tempo. Substituí-la por hardware bare metal que operamos nós mesmos eliminou essa dependência e colocou todo o caminho sob nossa própria operação. Toda requisição que você envia passa pelo Cortex agora, e o roteador é a parte que decide para onde cada requisição vai.
Para cada requisição, o roteador escolhe o caminho: qual região a recebe, qual node a atende, e o que acontece se esse node degradar no meio do processo. "Melhor rota até sua chain" na prática significa o node saudável de menor latência capaz de responder corretamente a essa chamada específica, agora. Essa resposta muda a cada segundo, conforme carga e saúde variam, e é por isso que recalculamos por requisição em vez de resolver uma vez e reutilizar o resultado.
A metade regional disso já é padrão no setor. Uma requisição de Singapura e outra de Frankfurt entrarão em pontos diferentes em qualquer provedor relevante, e nenhum deles exige que você configure isso. O que adicionamos é a segunda decisão, feita por requisição em vez de por conexão: entre os nodes disponíveis na região onde a requisição chegou, qual está saudável, atualizado e adequado a essa chamada específica.
Como uma requisição chega à região certa?
DNS baseado em geolocalização resolve o endpoint para a região de borda mais próxima, então uma requisição entra no sistema perto de onde ela se origina, em vez de todo o tráfego cair no mesmo lugar. Isso acontece antes de o roteador olhar para qualquer node, porque a distância até a porta de entrada é tempo de ida e volta puro, que você nunca recupera. O estabelecimento de conexão e a negociação TLS também acontecem ali, no ponto mais próximo, em vez de mais fundo na pilha.
Essa porta de entrada é nosso próprio Alchemy Edge Proxy, uma camada de ingestão bare metal que operamos em vez de uma CDN de terceiros. Colocá-la em produção foi um dos maiores ganhos de latência de toda a reconstrução. O P99 na Ásia-Pacífico foi de 150ms para 20ms, e o P95 em todas as networks caiu quase pela metade, de cerca de 200ms para cerca de 100ms. Esses são o antes e o depois dessa migração, não onde os números estão hoje, e P95 e P99 são os 5% e 1% mais lentos das requisições, que é a parte que os usuários realmente sentem. A borda é uma camada de um esforço mais amplo em latência que vai desde escalonamento preditivo até automação de frota.
Como escolhemos o node dentro de uma região?
Duas camadas fazem trabalhos diferentes aqui. Na borda, o control plane olha quais serving stacks suportam a network solicitada e quais delas estão saudáveis, e então envia a requisição para a mais próxima. Mas a escolha do node acontece uma camada mais abaixo, no gateway na frente da frota. Esse gateway é a primeira coisa no caminho que sabe algo sobre máquinas individuais.
Escolher um node bem exige mais do que escolher um próximo, então várias coisas reduzem a lista de candidatos antes que qualquer coisa seja encaminhada.
- Saúde, a partir de monitoramento ao vivo. Um sistema de rastreamento de nodes executa verificações de saúde contínuas, e um node que falha nelas não é candidato. Isso é o que impede que um backend degradado seja escolhido logo de início, em vez de ser descoberto pelos seus usuários.
- Concordância sobre o estado atual. Nem todos os nodes estão no mesmo bloco, então entregar uma leitura a qualquer um que responda mais rápido pode retornar um estado que a chain já ultrapassou. Uma camada de consistência mantém as requisições na mesma visão canônica da chain, independentemente de qual node as atende, e atualizações versionadas garantem que você não receba uma leitura desatualizada mesmo durante um failover em andamento.
- Latência observada, não só geografia. Os candidatos são pontuados por uma média móvel exponencialmente ponderada de sua latência medida recentemente, a mesma abordagem que balanceadores de carga usam há anos. Como amostras antigas perdem peso na média, um node que começou a ficar lento minutos atrás cai no ranking sozinho, sem que ninguém precise disparar um alerta.
- Formato da carga de trabalho. Clientes de node diferem em comportamento de sincronização e em quais métodos atendem bem, e nodes de arquivo e nodes completos guardam dados diferentes, então o método e os parâmetros da requisição reduzem ainda mais o conjunto de candidatos. Uma consulta histórica pesada e uma leitura de saldo simples não devem cair no mesmo node.
Então "menor latência" nunca é uma configuração que ligamos em algum lugar. Ela é recalculada a cada chamada, a partir de onde essa chamada entrou, do que ela está pedindo e de quais máquinas estão rápidas e saudáveis naquele momento.
O que acontece quando o node escolhido não está saudável?
O failover faz parte da decisão de roteamento, e não é um alarme colado ao lado dela. Quando um node cai, o Cortex redireciona o tráfego para nodes saudáveis automaticamente. O caso mais interessante é o do node que não falhou de vez, mas está congestionado, atrasado ou rodando uma versão de cliente com um bug conhecido, e o mesmo roteamento sensível ao contexto desvia desses casos também. Sua aplicação não vê um erro, e não há lógica de retry aqui para você escrever.
O mesmo vale uma camada acima. Se uma região inteira estiver degradada, as requisições são roteadas para uma região secundária, e há mais um fallback atrás dessa. A replicação global em tempo real mantém todas as regiões consistentes durante essas transições, então acabar em uma região mais distante não significa ler dados mais antigos.
Shuffle sharding e pools redundantes de nodes sustentam tudo isso, mantendo as falhas isoladas e contidas em vez de deixar um problema se espalhar pela frota. A camada de roteamento trata um node degradado como um caminho a evitar, a mesma tolerância a falhas por trás do nosso streaming gRPC de Solana com zero downtime e da frota que permaneceu no ar durante o maior evento de liquidação da cripto.
Por que operar a borda torna o roteamento mais inteligente?
O tráfego de RPC é, na maior parte, dinâmico. Um eth_call ou o envio de uma transação não podem ser armazenados em cache como uma imagem estática, então o principal truque de uma CDN genérica, servir conteúdo em cache perto do usuário, na maior parte não se aplica, e a requisição ainda precisa chegar a um node ativo. Operar a borda em vez de alugar uma CDN nos permite ajustá-la para esse formato de tráfego específico, e permite que o roteamento use sinais que uma camada de terceiros nunca vê, como qual node está sincronizado, saudável e mais rápido para este método e esta chain agora.
Também significa que não estamos compartilhando essa camada com tráfego alheio. Em uma CDN compartilhada, um incidente que não tem nada a ver com seu app ainda pode aparecer como um pico de latência seu, e a correção fica no cronograma de outra pessoa.
Onde os provedores realmente se diferenciam é em tudo abaixo da região, porque é ali que uma camada de roteamento ou sabe o que cada máquina está fazendo, ou está adivinhando.
Operamos isso nós mesmos porque é a única forma de garantir que nenhum trecho do caminho pertença a outra pessoa. Pagamos um custo de engenharia real por isso, e em troca podemos ajustar todo o caminho em vez de abrir um chamado com quem quer que seja o dono da parte lenta.
O que isso significa para uma chain como Base?
Base é um bom teste de estresse, porque a chain em si é rápida. Ela entrega atualizações incrementais de bloco a cada 200ms via Flashblocks, então um caminho de RPC que demore mais que isso para responder vira o gargalo, não a chain. Uma chamada Base de qualquer região entra na borda mais próxima, é associada a um node Base saudável e atualizado com a chain, e é redirecionada dentro da região se esse node degradar. Remover cem milissegundos de overhead de rede importa mais, não menos, quando a chain prévia um novo estado a cada 200ms.
Consistência é a garantia mais difícil, e é a que vale a pena usar para nos julgar. Polymarket é o caso de estresse. Durante as eleições americanas de 2024, eles registraram mais de 125.000 usuários simultâneos e US$ 3,3 bilhões em apostas, com requisições redirecionadas dinamicamente com base na latência p99 para manter o desempenho. Seus fluxos críticos de ingestão de dados, separadamente, ficaram 2,5x mais rápidos, saindo de cerca de 250ms para cerca de 100ms. Uma mediana medida em uma região em uma tarde tranquila quase não diz nada sobre o que seus usuários recebem durante um mint ou uma cascata de liquidações. Se preferir conferir em vez de confiar na nossa palavra, nossa metodologia de benchmark mede latência junto com taxa de sucesso e requisições falhas, e os benchmarks de provedores são públicos.
Construa sobre o mesmo caminho de roteamento
Todo app na Alchemy já passa por esse motor, sem nada a configurar. Crie um endpoint RPC gratuito e suas leituras e escritas seguem o mesmo caminho por requisição descrito aqui. Sem contrato, sem lista de espera, sem mudar de endpoint. Suas chamadas de Data API também rodam sobre ele.
Se você precisa de um node fixado em uma região, isolamento single-tenant, ou um binário customizado no caminho, os Alchemy Dedicated Clusters executam o mesmo roteamento em hardware single-tenant, e você pode optar por failover automático para a frota compartilhada caso o tráfego ultrapasse a capacidade do cluster. De qualquer forma, a requisição por trás do seu app é a parte que você para de pensar.
Perguntas frequentes
Qual provedor de RPC entrega a menor latência entre regiões globais?
O tempo médio de resposta da Alchemy entre chains EVM é abaixo de 15ms em nossos benchmarks atualizados continuamente, medido como tempo de requisição-e-resposta "quente" em uma conexão já aberta. Essa página é recalculada a cada poucos minutos, então leia o ranking atual de provedores diretamente nela. O uptime é de 99,995%. Todo provedor sério te roteia para uma região próxima. O Cortex vai além dentro dessa região, associando cada requisição a um node verificado quanto à saúde e à concordância sobre o estado atual da chain.
Qual provedor de RPC suporta Base RPC com a menor latência?
O Base RPC na Alchemy entra na região de borda mais próxima e depois é associado a um node Base saudável e atualizado com a chain. Isso importa mais no Base do que em chains mais lentas, porque o Flashblocks empurra atualizações de bloco a cada 200ms, então um node mesmo levemente atrasado pode retornar um estado que já mudou.
Como o Cortex escolhe qual node atende uma requisição RPC?
Duas camadas dividem o trabalho. O control plane na borda escolhe a serving stack saudável mais próxima que suporta a network solicitada, e o gateway na frente da frota então escolhe o node, reduzindo os candidatos por saúde, concordância sobre o estado atual da chain, latência observada recentemente e o método chamado.
O roteamento por requisição adiciona latência?
O roteamento é uma fatia pequena do orçamento de resposta, não o número principal. O valor abaixo de 15ms é o tempo de requisição-e-resposta "quente" entre chains EVM, não o custo da decisão de roteamento em si, e não é a mesma medida da média abaixo de 50ms em toda a plataforma, considerando todas as chains e produtos. A seleção de região acontece na borda, perto do usuário, e a seleção de node acontece mais fundo, no gateway que fica na frente da frota.
O que acontece quando um node de RPC falha?
O failover faz parte da decisão de roteamento, e não é um retry que você mesmo implementa. O Cortex redireciona o tráfego para nodes saudáveis automaticamente quando um cai, e seu roteamento sensível ao contexto também desvia de nodes congestionados, atrasados ou rodando um cliente com bugs. Se uma região inteira degradar, as requisições se movem para uma região secundária, com replicação em tempo real mantendo os dados consistentes.
Newsletter da Alchemy
Seja o primeiro a saber sobre lançamentos
Assine nossa newsletter
Receba as últimas atualizações de produtos e recursos da Alchemy
Ao inserir seu endereço de e-mail, você concorda em receber nossas comunicações de marketing e atualizações de produtos. Você reconhece que a Alchemy processa as informações que recebemos de acordo com nosso Aviso de Privacidade. Você pode cancelar a inscrição a qualquer momento.

Artigos relacionados

Por que equipes de trading escolhem a Alchemy para RPC de baixa latência
Equipes de trading escolhem a Alchemy por leituras e escritas de baixa latência quando o mercado se move, e por um registro confiável quando o dinheiro liquida, mesmo no pico de volume.

Em qual provedor de RPC você deve construir em Tóquio?
Comparamos cinco dos provedores de RPC que atendem Tóquio em cinco chains. Veja como eles se comparam e onde as diferenças importam para equipes sensíveis à latência.

Arquitetando leituras Solana RPC para velocidade e confiabilidade líderes do setor
A Alchemy tem a menor latência de leitura Solana: 9,21 ms, cerca de 26% mais rápido que o próximo provedor.