Cortexルーター:あらゆるリクエストに対して最速の健全なノードを選ぶ仕組み
著者: Uttam Singh
アプリが発行するRPCコールはすべて、ユーザーに何かが表示される前に、ノードに到達して戻ってこなければなりません。そのコールを近くのリージョンに届けることは、真剣に取り組んでいるプロバイダーなら誰でも自動的にやっていることで、Alchemyも同様です。さらに最初のホップを短くするために、リージョンを増やし続けています。より興味深い問いは、そこに到達した後に何が起こるかです。そのリージョン内のどのノードが応答するのか、そしてそのノードが健全でチェーンに追いついていることを、リクエストを送る前に何かがチェックしたのか、という点です。
その2番目の判断は、リクエストごとに新たに下しているものであり、EVMチェーン全体での平均レスポンスタイムが15ms未満である理由の大部分を占めています。この数値はウォームなリクエスト・レスポンス時間であり、すでに開いている接続上で計測したものです。これは稼働中のアプリからの繰り返しトラフィックが実際に経験する状況に相当します。DNS、接続確立、TLSハンドシェイクは含まれていないため、後述するエッジでの処理はこの数値の内側ではなく外側にあります。
Cortexルーターは実際に何を決定しているのか?
Cortexは、ノードフリートからルーティング層、その上のRPCとData APIまで、Alchemyプラットフォーム全体を動かしているエンジンです。以前の構成では、トラフィックの前段にサードパーティのCDNを置いていましたが、そのため、そのCDNがすべてのネットワーク・すべての顧客にとって単一障害点になっていました。それを自社で運用するベアメタルに置き換えたことで、その依存関係が取り除かれ、経路全体が自社の運用下に入りました。現在、送信されるすべてのリクエストはCortexを通過し、ルーターがそのリクエストをどこに送るかを決定する部分です。
各リクエストについて、ルーターは経路を選びます。どのリージョンが受け付けるか、どのノードが処理するか、そしてそのノードが処理途中に不調になったらどうするか、です。「あなたのチェーンへの最適経路」が実際に意味するのは、今この瞬間、この特定のコールに正しく答えられる、レイテンシが最も低く健全なノードということです。その答えは負荷や健全性の変化に応じて秒単位で変わるため、一度解決してその結果を使い回すのではなく、リクエストごとに再計算しています。
そのうちリージョン側の部分は、今や業界標準になっています。シンガポールからのリクエストとフランクフルトからのリクエストは、どの大手プロバイダーでも異なる地点で入ってきますし、それを自分で設定する必要はどこもありません。Alchemyが加えているのは2番目の判断で、これは接続単位ではなくリクエスト単位で行われます。リクエストが入ったリージョン内で利用可能なノードのうち、どれが健全で、最新で、その特定のコールに適しているか、という判断です。
リクエストはどうやって適切なリージョンに到達するのか?
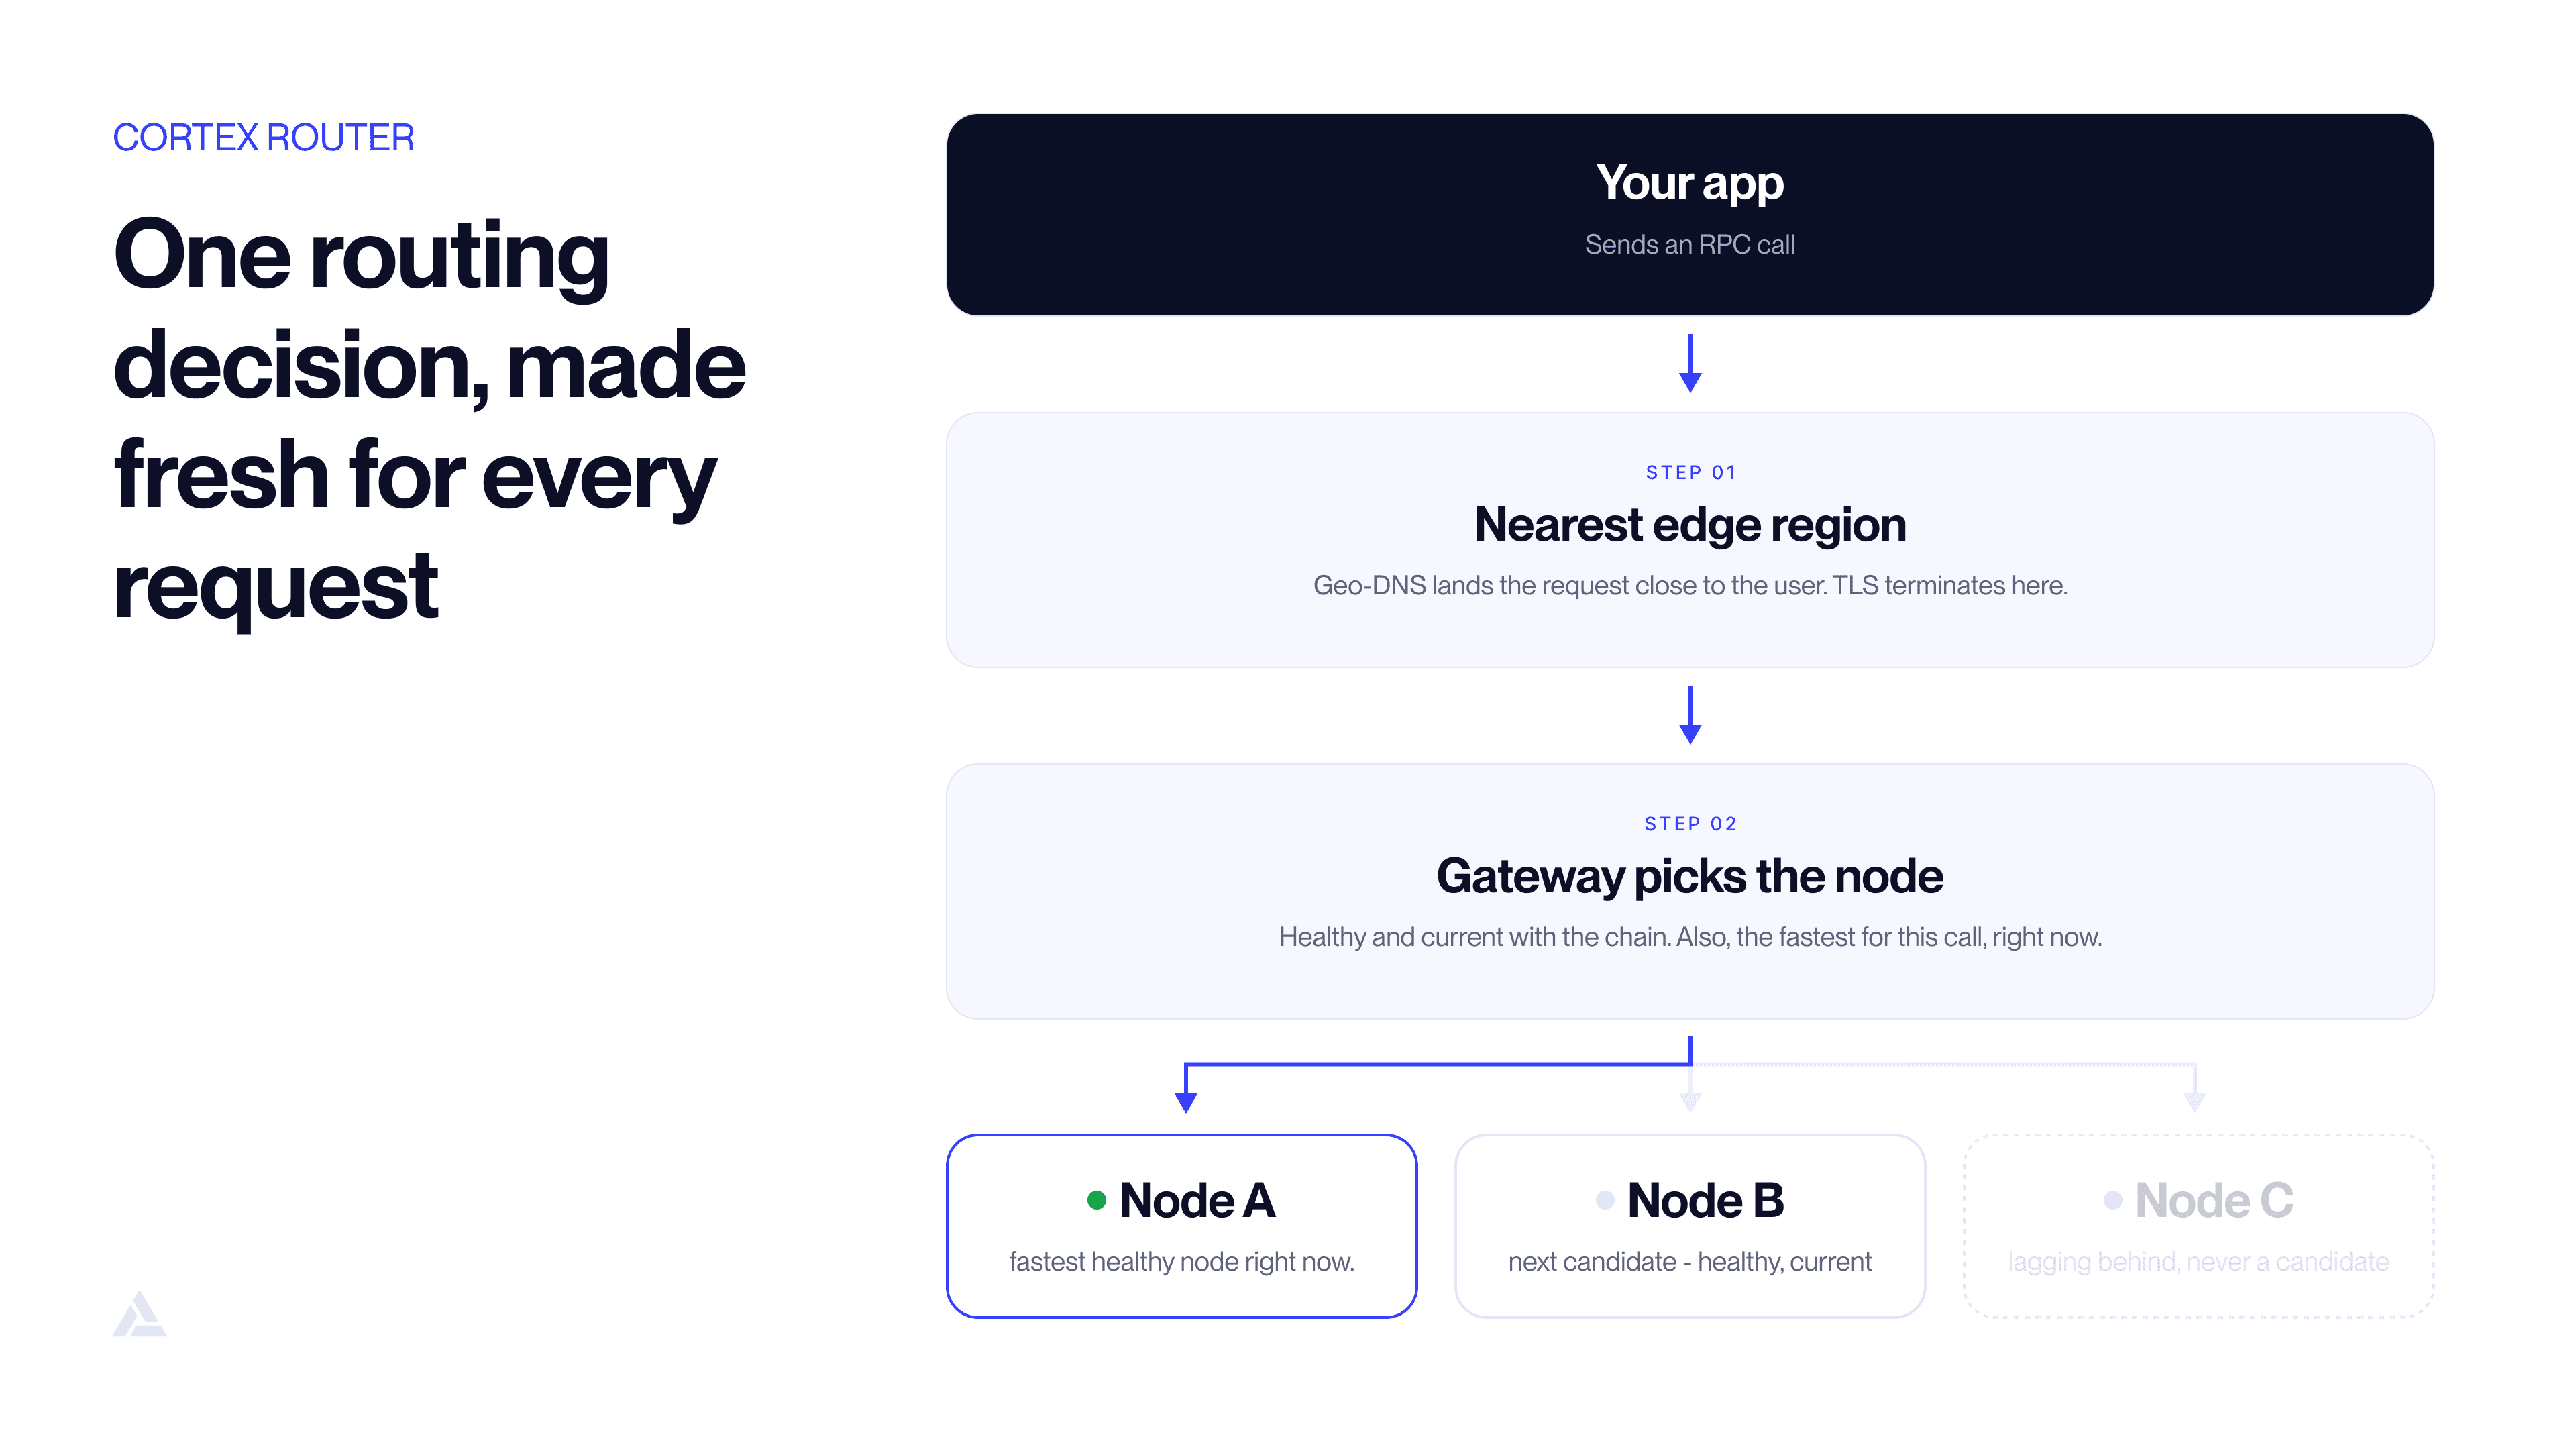
地理ベースのDNSがエンドポイントを最寄りのエッジリージョンに解決するため、すべてのトラフィックが一箇所に集中するのではなく、リクエストは発生元に近い場所でシステムに入ります。これはルーターが1つでもノードを見る前に行われます。玄関口までの距離は純粋な往復時間であり、一度失えば取り戻せないものだからです。接続確立とTLSネゴシエーションも、スタックの奥深くではなく、この最も近い地点で行われます。
その玄関口が、サードパーティのCDNではなく自社で運用しているベアメタルのイングレス層、Alchemy Edge Proxyです。これを展開したことは、この再構築の中でも最大級のレイテンシ改善の1つでした。アジア太平洋地域のP99は150msから20msになり、全ネットワークにおけるP95はおよそ200msからおよそ100msへと、ほぼ半分になりました。これらの数値はこの移行の前後の比較であり、現在の水準を示すものではありません。また、P95・P99はそれぞれ最も遅い5%、1%のリクエストのことで、実際にユーザーが体感する部分です。エッジはレイテンシ全体に対する取り組みの1つの層に過ぎず、この取り組みは予測スケーリングからフリートの自動化までにわたっています。
リージョン内でのノード選定はどう行っているのか?
ここでは2つの層がそれぞれ異なる仕事をしています。エッジでは、コントロールプレーンが、要求されたネットワークをどのサービングスタックがサポートしているか、そしてそのうちどれが健全かを見て、最も近いものにリクエストを送ります。しかし、ノードの選定はさらに1層深い、フリートの手前にあるゲートウェイで行われます。このゲートウェイが、経路上で個々のマシンについて何かを知っている最初のポイントです。
ノードをうまく選ぶには、近いノードを選ぶだけでは足りません。そのため、転送前にいくつかの要素が候補リストを絞り込みます。
- ライブトラッキングによる健全性。 ノードトラッキングシステムが継続的にヘルスチェックを実行しており、それに失敗したノードは候補になりません。これにより、劣化したバックエンドが最初から選ばれないようになっており、ユーザーがそれを発見することにはなりません。
- 現在の状態についての合意。 すべてのノードが同じブロックにいるわけではないため、単に一番早く応答したノードに読み取りを任せると、チェーンがすでに通り過ぎた状態を返してしまうことがあります。一貫性レイヤーが、どのノードが処理しても同じ正準なチェーンのビューを保つようにしており、バージョン管理された更新により、フェイルオーバーの最中であっても古い読み取りに当たることはありません。
- 地理だけでなく、観測されたレイテンシ。 候補は、直近で計測されたレイテンシの指数加重移動平均でスコア付けされます。これはロードバランサーが長年使ってきた手法と同じです。古いサンプルは平均から減衰していくため、数分前から遅くなり始めたノードは、誰かがアラートを上げるまでもなく、ランキングを自然と下げていきます。
- ワークロードの性質。 ノードクライアントは同期の振る舞いや得意なメソッドが異なり、アーカイブノードとフルノードでは保持しているデータも異なるため、リクエストのメソッドとパラメータによって候補プールはさらに絞られます。重いヒストリカルクエリと単純な残高照会が同じノードに送られるべきではありません。
つまり「最小レイテンシ」は、どこかでオンにするような設定ではありません。それは呼び出しごとに、どこから入ってきたリクエストなのか、何を要求しているのか、そしてその瞬間にどのマシンが速く健全なのかに基づいて、毎回再計算されるものです。
選ばれたノードが健全でない場合はどうなるのか?
フェイルオーバーは、後から取り付けたアラームではなく、ルーティングの判断そのものの一部です。ノードがダウンすると、Cortexは自動的にトラフィックを健全なノードへ再ルーティングします。より興味深いケースは、完全には障害に至っていないものの、輻輳している、遅延している、あるいは既知のバグがあるクライアントバージョンを実行しているノードで、同じコンテキスト認識型ルーティングがそうしたノードも回避します。あなたのアプリケーションにエラーは表示されませんし、ここには自分で書くべきリトライロジックはありません。
同じことが1つ上のレベルでも当てはまります。リージョン全体が劣化した場合、リクエストは別のリージョンにルーティングされ、その先にさらにフォールバックがあります。リアルタイムのグローバルレプリケーションが、これらの移行の間もすべてのリージョンを一貫した状態に保つため、より遠いリージョンに行き着いたとしても、古いデータを読むことにはなりません。
シャッフルシャーディングと冗長なノードプールが、これらすべての基盤にあり、障害を分離・封じ込め、1つの問題がフリート全体に広がらないようにしています。ルーティング層は劣化したノードを避けるべき経路として扱いますが、これはゼロダウンタイムのSolana gRPCストリーミングや、クリプト史上最大級の清算イベントを通じて稼働し続けたフリートを支えているのと同じ耐障害性です。
エッジを自社で保有することが、なぜルーティングをより賢くするのか?
RPCトラフィックの大半は動的です。eth_callやトランザクション送信は、静的画像のようにはキャッシュできません。そのため、汎用CDNの主なトリック、つまりユーザーの近くにキャッシュ済みコンテンツを配信するという手法は、ほとんど当てはまらず、それでもリクエストは稼働中のノードに到達する必要があります。CDNを借りるのではなく自社でエッジを保有することで、この特定のトラフィックの形状に合わせてチューニングでき、また、どのノードが同期済みで健全か、このメソッドとチェーンに対して今どれが最速かといった、サードパーティ層では決して見えないシグナルをルーティングに使うことができます。
また、その層を無関係なトラフィックと共有していないということでもあります。共有CDN上では、あなたのアプリとは何の関係もないインシデントが、あなたのレイテンシスパイクとして表面化することがあり、その修正は他人のスケジュール次第です。
プロバイダー間で実際に差が出るのは、リージョンより下のすべての部分です。なぜなら、そこはルーティング層が各マシンの状況を実際に把握しているか、それとも推測しているだけかが分かれる場所だからです。
Alchemyがこれを自社で運用しているのは、それが経路のどの区間も他者のものにならないようにする唯一の方法だからです。そのために実際のエンジニアリングコストを払っていますが、その見返りとして、遅い部分を所有している誰かにチケットを出す代わりに、経路全体をチューニングすることができます。
これはBaseのようなチェーンにとって何を意味するのか?
Baseは良いストレステストです。なぜなら、チェーン自体が高速だからです。Flashblocksによる200msの逐次ブロック更新を提供しているため、それより応答に時間がかかるRPC経路は、チェーンではなくRPC経路自体がボトルネックになってしまいます。どのリージョンからのBaseコールも最寄りのエッジに入り、チェーンに追いついている健全なBaseノードにマッチングされ、そのノードが劣化した場合はリージョン内で再ルーティングされます。100ミリ秒のネットワークオーバーヘッドを削減することは、チェーンが200msごとに新しい状態をプレビューする状況では、より重要になりこそすれ、軽くはなりません。
一貫性のほうがより難しい保証であり、これこそAlchemyを評価する際に見るべきポイントです。Polymarketはそのストレスケースです。2024年の米国大統領選挙を通じて、彼らは12万5000人以上の同時ユーザーと33億ドルの賭けを処理しましたが、その際、p99レイテンシに基づいてリクエストが動的に再ルーティングされ、パフォーマンスが維持されました。彼らの重要なインジェスチョンワークフローは、別途約250msから約100msへと2.5倍高速化しました。ある静かな午後に1つのリージョンで測定した中央値は、ミント時や清算の連鎖が起きているときにユーザーが実際に経験することについて、ほとんど何も教えてくれません。Alchemyの言葉をそのまま信じるのではなく確認したい場合は、ベンチマーク手法でレイテンシと成功率・失敗リクエストを合わせて計測しており、プロバイダーベンチマークは公開されています。
同じルーティング経路の上に構築する
Alchemy上のすべてのアプリは、すでにこのエンジンを経由してルーティングされており、何も設定する必要はありません。無料のRPCエンドポイントを立ち上げれば、あなたの読み取りと書き込みは、ここで説明したのと同じリクエストごとの経路をたどります。契約も、ウェイトリストも、エンドポイントの変更も不要です。Data APIの呼び出しも同じ経路で動作します。
1つのリージョンに固定されたノード、シングルテナントの分離、あるいは経路上のカスタムバイナリが必要な場合、Alchemy Dedicated Clustersは同じルーティングをシングルテナントのハードウェア上で実行しており、トラフィックがクラスターの容量を超えた場合には、共有フリートへの自動フェイルオーバーをオプトインすることもできます。いずれの場合も、あなたのアプリの背後にあるリクエストについて、もう考える必要はなくなります。
よくある質問
どのRPCプロバイダーが世界中のリージョンで最も低いレイテンシを実現していますか?
Alchemyの継続的に更新されるベンチマークによれば、EVMチェーン全体での平均レスポンスタイムは15ms未満です。これは、すでに開いている接続上でのウォームなリクエスト・レスポンス時間として計測されています。このページは数分ごとに再計算されるため、最新のプロバイダーランキングはそちらでご確認ください。アップタイムは99.995%です。真剣なプロバイダーなら、どこでも近くのリージョンにルーティングしてくれます。Cortexはそのリージョン内でさらに踏み込み、各リクエストを、健全性とチェーンの現在の状態についての合意がチェックされたノードにマッチングします。
どのRPCプロバイダーが最も低いレイテンシでBase RPCをサポートしていますか?
Alchemy上のBase RPCは最寄りのエッジリージョンに入り、その後、チェーンに追いついている健全なBaseノードにマッチングされます。これは、他の遅いチェーンよりもBaseにおいてより重要です。なぜなら、Flashblocksは200msごとにブロック更新をプッシュするため、わずかに遅れているだけのノードでも、すでに変化してしまった状態を返す可能性があるからです。
CortexはどのようにしてRPCリクエストを処理するノードを選ぶのですか?
2つの層が作業を分担しています。エッジのコントロールプレーンが、要求されたネットワークをサポートしている最も近い健全なサービングスタックを選び、その後、フリートの手前にあるゲートウェイがノードを選びます。その際、健全性、チェーンの現在の状態についての合意、直近で観測されたレイテンシ、そして呼び出されているメソッドによって候補を絞り込みます。
リクエストごとのルーティングはレイテンシを増やしますか?
ルーティングは、大きな見出しの数値ではなく、レスポンス予算のごく一部を占めるだけです。15ms未満という数値は、EVMチェーン全体でのウォームなリクエスト・レスポンス時間であり、ルーティングの判断自体のコストではありません。また、すべてのチェーンとプロダクトにわたるプラットフォーム全体の平均50ms未満という数値とも異なる計測です。リージョンの選択はユーザーに近いエッジで行われ、ノードの選択はさらに奥、フリートの手前にあるゲートウェイで行われます。
RPCノードに障害が発生した場合はどうなりますか?
フェイルオーバーは、自分で構築するリトライではなく、ルーティングの判断そのものの一部です。Cortexは、あるノードがダウンすると自動的にトラフィックを健全なノードへ再ルーティングし、そのコンテキスト認識型ルーティングは、輻輳している、遅延している、あるいはバグのあるクライアントを実行しているノードも回避します。リージョン全体が劣化した場合は、リクエストは別のリージョンに移動し、リアルタイムのレプリケーションがデータの一貫性を保ちます。
Alchemy Newsletter
リリース情報をいち早く受け取る
ニュースレターに登録する
Alchemyの最新のプロダクト情報とリソースをお届けします
メールアドレスを入力すると、当社のマーケティング情報およびプロダクト最新情報の受信に同意したことになります。Alchemyが受け取った情報をプライバシー通知に従って取り扱うことに同意するものとします。購読はいつでも解除できます。

関連記事

トレーディングチームが低レイテンシーRPCにAlchemyを選ぶ理由
トレーディングチームがAlchemyを選ぶのは、市場が動くときの低レイテンシーな読み取りと書き込み、そして出来高のピーク時でも資金が決済される際の信頼できる記録のためだ。

東京で構築するなら、どのRPCプロバイダーを選ぶべきか
東京を提供するRPCプロバイダー5社を、5つのチェーンでベンチマークした。比較結果と、レイテンシに敏感なチームにとって差が出るポイントを示す。

業界最速クラスの速度と信頼性を実現するSolana RPC読み取りの設計
AlchemyはSolanaの読み取りレイテンシが最も低く、9.21ミリ秒で、次点のプロバイダーより約26%高速です。