¿Qué es un blockchain indexer?

Escrito por Usman Asim
Un blockchain indexer convierte una cadena de bloques en datos que una aplicación puede buscar. Un nodo devuelve el bloque 21,000,000. Por sí solo no devuelve cada transferencia de USDC a una billetera, ni cada posición que abrió un contrato de préstamos. Esas respuestas exigen que alguien lea la cadena, decodifique los logs y guarde el resultado.
Los equipos ejecutan ese pipeline o llaman una API administrada que ya hizo el trabajo. Las preguntas estándar (saldos de tokens, historial de transferencias, NFTs, precios) suelen ser una API administrada. Las preguntas propias (tus tablas, tus eventos, SQL sobre el estado del protocolo) suelen ser un indexer que operas tú.
Cómo funcionan los blockchain indexers tiene la misma forma en ambos casos: extraer bloques, transformarlos en registros y cargarlos donde una consulta pueda encontrarlos. Sin embargo, las respuestas guardadas quedan mal cuando la cadena reemplaza un bloque reciente y conservas las filas viejas, cuando el historial sigue sin leerse, o cuando el trabajo se detiene a mitad de una escritura. En esta guía: cómo se arma el pipeline, qué hacer en cada uno de esos tres casos, un ciclo de indexación que puedes ejecutar, y cuándo construir un indexer o llamar una API administrada.
¿Qué es un blockchain indexer?
Un blockchain indexer es un servicio que lee bloques nuevos de un nodo, decodifica transacciones y logs de eventos, y los escribe en una base de datos hecha para búsquedas. Las apps consultan esa base, o una API delante de ella, en lugar de escanear la cadena desde el primer bloque en cada petición.
Las blockchains guardan los bloques en orden. Ese orden es lo que necesita el consenso. No te deja buscar una billetera. En el nodo no hay SELECT * FROM transfers WHERE to = .... La llamada más cercana en Ethereum es un método como eth_getLogs o eth_getBlockByNumber, que devuelve un bloque, o un rango de logs. Encontrar "todo lo que hizo esta dirección" significa repetir esa llamada a lo largo del historial y conservar el resultado.
Un indexer hace ese trabajo por adelantado y guarda el resultado. El historial de una billetera, la propiedad de NFTs, el volumen de un DEX y las posiciones de préstamo son respuestas calculadas. La cadena no los guarda como un campo que puedas leer.
¿Cómo funcionan los blockchain indexers?
Un blockchain indexer corre un ciclo: toma un rango de bloques, decodifica los logs y las transacciones que te importan, escribe filas y guarda el último bloque que terminó. La siguiente corrida empieza en el bloque siguiente. No vuelves a leer la cadena desde el principio.
El ciclo tiene tres etapas.
- Extraer. Lee bloques, recibos o logs de un nodo. Para mantenerte al día, lee cada bloque nuevo cuando se agrega. Para alcanzar los bloques viejos, léelos en rangos chicos.
- Transformar. Decodifica el hex crudo con el ABI del contrato. Un hash de topic se vuelve el nombre de un evento. Un
uint256en wei se vuelve una cantidad de tokens. También puedes guardar un timestamp o un precio en la fila. - Cargar. Inserta las filas decodificadas en una base de datos. Agrega un índice en las columnas que vas a buscar: dirección, contrato, token id, número de bloque. Sirve esas filas por una API.
Ese es todo el ciclo. El resto de esta página explica cómo mantener esas filas correctas cuando la cadena reemplaza bloques recientes, cuando todavía hay años de historial sin leer y cuando el proceso se cae a la mitad.
¿Cuál es la arquitectura de un blockchain indexer?
La mayoría de los indexers, los operes tú o un proveedor, son cuatro piezas: una fuente de datos, un motor de indexación, una base de datos y una API. El motor es el código que decodifica logs, descarta filas cuando la cadena reemplaza un bloque y lee bloques viejos en rangos. La base es lo que consulta la app, así una búsqueda de una dirección no lee cada fila que guardaste.
Fuente de datos
La fuente de datos es el JSON-RPC del nodo o un endpoint de un proveedor delante de él. El indexer pide bloques nuevos, las transacciones de esos bloques y los logs que emitieron los contratos. Algunos indexers también leen traces, que muestran el valor movido dentro de una transacción, no solo la llamada de nivel superior.
Motor de indexación
El motor de indexación decodifica lo que devolvió el nodo y decide qué guardar. Un log crudo es una lista de hashes de topic más un campo data. El motor usa el ABI del contrato para convertirlo en un registro que puedes leer: una transferencia de token, un swap, una posición liquidada.
También mantiene un saldo actual. Una cadena guarda cada cambio, no una respuesta lista a "¿qué tiene esta billetera ahora?". Los saldos y la propiedad son la suma de cada transferencia hasta ahora. El motor mantiene esa suma mientras avanza, o guarda las transferencias y calcula la suma cuando alguien pregunta.
Un índice de base de datos en to_address es cómo encuentras las transferencias de una billetera sin leer cada fila.
Base de datos
La base de datos guarda las filas decodificadas. Las preguntas que haces deciden qué tipo usar:
- Las bases relacionales como PostgreSQL sirven para transferencias, saldos y joins entre bloques, direcciones y contratos.
- Los almacenes de documentos sirven para registros cuyos campos cambian de un contrato a otro.
- Las bases de grafos sirven para preguntas de conexiones: qué billeteras enviaron tokens a qué billeteras, y qué pools comparten liquidez.
- Los warehouses como BigQuery sirven para escaneos grandes y totales, no para una consulta que un usuario espera mientras carga una página.
Una configuración habitual escribe las mismas filas dos veces: una vez en la base que lee la app y otra en un warehouse que consultan los analistas.
API
La API es lo que llama la app. GraphQL deja que el cliente elija campos. REST sirve para consultas conocidas como "transferencias de esta dirección". Un websocket o un webhook envía a la app una fila nueva cuando se escribe, para que la app no tenga que seguir preguntando.
El caché, los límites de tasa y las API keys están en esta capa, para que un cliente no pueda sobrecargar la base.
¿Cómo manejan los indexers los reorgs?
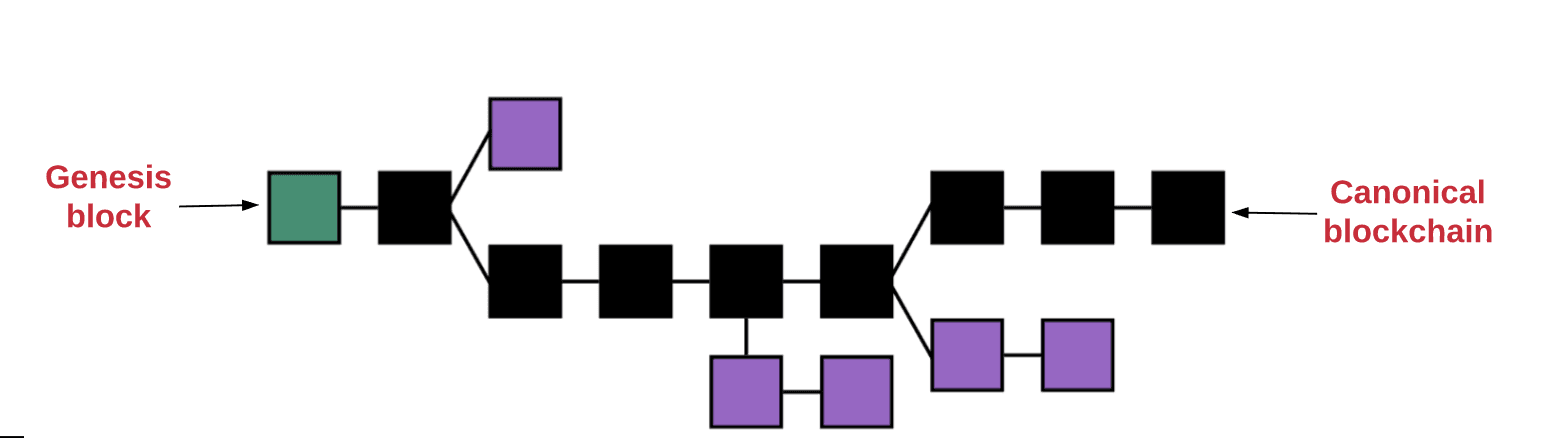
Un indexer maneja un reorg al notar que un bloque guardado ya no es el padre del bloque más nuevo, borrar las filas de los bloques que fueron reemplazados e indexar los bloques nuevos. Si omites ese paso, la base todavía contiene transacciones que la red no conservó.
Un reorg ocurre cuando el consenso reemplaza un tramo corto de bloques recientes, en general solo unos pocos. Si lo ignoras, una transferencia que mostraste al usuario nunca se confirmó, o un saldo que guardaste está mal.
Una comprobación práctica en cada bloque nuevo:
- Lee el header del bloque nuevo y su
parentHash. - Compara ese hash con el hash que guardaste para el bloque anterior.
- Si coinciden, decodifica e inserta.
- Si no, camina hacia atrás hasta el ancestro común.
- Borra cada fila de los bloques posteriores a ese ancestro compartido.
- Indexa hacia adelante desde el ancestro por los bloques que la red conservó.
Los logs también pueden llegar con removed: true. Trata esa marca como un borrado, no como otra inserción. Dale a cada fila una clave única que la cadena ya da, como (chain_id, transaction_hash, log_index), para que escribir el mismo log otra vez no lo cuente dos veces.
Si tu producto puede esperar, indexa solo los bloques que el nodo marca como finalized o safe. Esos ya pasaron el punto en el que un reemplazo sigue siendo probable. Esperas un poco más y casi no tienes que borrar filas. Un bloque etiquetado latest todavía puede ser reemplazado, así que un indexer que sigue el bloque más nuevo no puede tratarlo como permanente.
¿Cómo funciona un backfill?
Un backfill es la primera lectura de los bloques viejos. El indexer camina desde un bloque inicial hasta el bloque más nuevo en rangos fijos, escribe filas y guarda el último bloque terminado. Un reinicio continúa desde ese bloque en lugar de empezar de nuevo en el bloque cero.
El historial de Ethereum son decenas de millones de bloques. Una petición no puede contener eso. eth_getLogs es la herramienta habitual, y el rango que puedes pedir depende del plan y de la cadena. En el tier gratuito, una sola llamada se limita a 10 bloques. En Ethereum, Base, Optimism, Arbitrum, Polygon y las demás cadenas de la primera fila de la referencia de eth_getLogs, pay as you go y Enterprise no tienen tope de rango de bloques. Cada respuesta, en cualquier plan, sigue limitada a 150MB. En la mayoría de las otras cadenas, pay as you go permite 10,000 bloques por llamada. Monad testnet y Berachain son más bajos. La tabla lista cada cadena. Parte cualquier rango más grande. Una respuesta que pega el tope de bytes falla igual que un rango demasiado grande.
Un backfill que sobrevive a un fallo se ve así:
- Guarda un cursor: el último bloque que confirmaste por completo.
- Pide el siguiente rango, con un tamaño bajo el tope de esa cadena y ese plan.
- Decodifica y luego confirma las filas y el cursor nuevo en una transacción.
- Repite hasta que el bloque guardado alcance el bloque más nuevo.
- Pasa de leer rangos viejos a seguir bloques nuevos.
Guarda el cursor solo después de que las filas de ese rango estén guardadas. Si avanzas el cursor primero y luego se cae el proceso, esos bloques se saltan para siempre. Si escribes las filas primero y se cae antes de mover el cursor, la siguiente corrida las repite, lo cual es seguro si el mismo log no se puede insertar dos veces.
Los backfills en paralelo parten el rango entre workers. Igual necesitan un guardado ordenado único, o un paso de merge, para que dos workers no escriban versiones distintas del mismo bloque.
¿Cómo se recupera un indexer?
Recuperar significa empezar de nuevo desde el último bloque guardado que sigue en la cadena que la red conservó, y luego leer hacia adelante hasta el bloque más nuevo. Usas el mismo código que el backfill, sobre un tramo más corto de bloques.
Cuando un proceso vuelve después de una caída, no des por válido el bloque guardado:
- Carga el número de bloque guardado y el hash del bloque.
- Vuelve a pedir ese bloque al nodo.
- Si el hash sigue coincidiendo, el bloque guardado sigue siendo el que la red conservó. Retoma desde el bloque siguiente.
- Si el hash no coincide, la cadena reemplazó bloques mientras estabas caído. Camina hacia atrás por los bloques padre hasta que el hash guardado coincida, revierte la base hasta ese bloque y retoma.
- Lee hacia adelante hasta el bloque más nuevo. No saltes los bloques faltantes para alcanzar más rápido. Esos bloques son las transferencias que perdiste.
El fallo que hay que evitar es un hueco: el bloque 18,000,000 guardado, el bloque 18,000,500 guardado y nada en el medio. Los usuarios no ven el hueco. Ven una transferencia faltante y un saldo incorrecto.
Dos hábitos hacen rutinaria la recuperación. Una clave única hace seguro escribir el mismo bloque otra vez. Guardar el cursor en la misma transacción de base de datos que las filas hace que una caída se detenga en un límite de bloque, no a la mitad de uno.
¿Cómo se ve un ciclo de indexación en código?
El ciclo de abajo es un backfill real de eth_getLogs contra Ethereum. Lee el bloque más nuevo, recorre una ventana de 10 bloques (el máximo del tier gratuito) e imprime cada log Transfer de USDC. Guárdalo como un archivo .js, define ALCHEMY_API_KEY y córrelo con Node 18 o más nuevo.
const url =
"https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

// keccak256("Transfer(address,address,uint256)")
const TRANSFER_TOPIC =
"0xddf252ad1be2c89b69c2b068fc378daa952ba7f163c4a11628f55a4df523b3ef";
const USDC = "0xA0b86991c6218b36c1d19D4a2e9Eb0cE3606eB48";

// Free tier: 10 blocks per eth_getLogs call. Widen this only on a plan
// whose range cap allows it. Responses are capped at 150MB on every plan.
const RANGE = 10;

async function rpc(method, params) {
const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({ jsonrpc: "2.0", id: 1, method, params }),
});
const body = await response.json();
if (body.error) {
  throw new Error(JSON.stringify(body.error));
}
return body.result;
}

async function backfill(fromBlock, toBlock) {
let cursor = fromBlock;
while (cursor <= toBlock) {
  const end = Math.min(cursor + RANGE - 1, toBlock);
  const logs = await rpc("eth_getLogs", [
    {
      fromBlock: "0x" + cursor.toString(16),
      toBlock: "0x" + end.toString(16),
      address: USDC,
      topics: [TRANSFER_TOPIC],
    },
  ]);

  for (const log of logs) {
    // removed: true means the log was on a block that got reorged out.
    if (log.removed) continue;
    const key = log.transactionHash + ":" + log.logIndex;
    console.log(key, log.blockNumber);
  }

  // In a real indexer, commit rows and this cursor in one transaction.
  cursor = end + 1;
}
}

async function main() {
const head = Number(await rpc("eth_blockNumber", []));
await backfill(head - (RANGE - 1), head);
}

main();
Una versión de producción escribe esos logs en una tabla con una clave única en (transaction_hash, log_index), guarda el cursor al lado y corre la comprobación de parent hash de la sección de reorgs antes de tratar el bloque más nuevo como final. Decodificar topics[1] y topics[2] da las direcciones indexadas from y to. El monto está en data.
Para el historial de una sola dirección, normalmente no deberías correr este ciclo. alchemy_getAssetTransfers devuelve ese historial página por página. Envía el pageKey devuelto en la llamada siguiente hasta que la respuesta ya no lo incluya. Cada llamada cuesta 120 compute units. eth_getLogs cuesta 60, y todavía tienes que paginar, decodificar y guardar.
async function main() {
const url =
  "https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    jsonrpc: "2.0",
    id: 1,
    method: "alchemy_getAssetTransfers",
    params: [
      {
        fromBlock: "0x0",
        toAddress: "0x5c43B1eD97e52d009611D89b74fA829FE4ac56b1",
        category: ["external", "erc20", "erc721", "erc1155"],
        withMetadata: true,
        excludeZeroValue: true,
        order: "desc",
        maxCount: "0x64",
      },
    ],
  }),
});

const body = await response.json();
// If body.result.pageKey is set, call again with that pageKey until it is absent.
console.log(body.result.transfers);
}

main();
category es obligatorio. Los valores son external, internal, erc20, erc721, erc1155 y specialnft. Las transferencias internas están disponibles en Ethereum mainnet, Polygon mainnet, Base mainnet, Arc mainnet y Arc testnet. withMetadata: true agrega un timestamp de bloque, en Ethereum, Base, Polygon, Arbitrum y Optimism. Los resultados se paginan a 1,000 filas. Envía el pageKey devuelto en la llamada siguiente hasta que la respuesta ya no lo incluya. Esa clave expira a los 10 minutos. order: "desc" devuelve primero lo más nuevo. order: "asc" devuelve primero lo más viejo.
Durante un fork o una caída parcial, toBlock: "indexed" lee del caché indexado en lugar del bloque más nuevo. Ese resultado puede quedar unos bloques atrás. Úsalo cuando un historial un poco más viejo es mejor que un error.
¿Conviene construir un indexer o usar una API administrada?
Usa una API administrada para saldos, transferencias, NFTs y precios. Construye un indexer cuando necesitas tus propias tablas: eventos propios, posiciones, reservas o una consulta SQL que ningún endpoint compartido devuelve.
Las Data APIs son el camino administrado para las lecturas comunes. Transfers API devuelve el historial de transferencias de una dirección en páginas de hasta 1,000, incluidas las externas, ERC-20, ERC-721 y ERC-1155, en lugar de escanear la cadena. Envía el pageKey devuelto en la llamada siguiente hasta que la respuesta ya no lo incluya. Token API devuelve metadatos y saldos. NFT API devuelve la propiedad. Prices API devuelve precios actuales e históricos. Portfolio API combina tokens, NFTs y transferencias, incluido un método de transferencias por billetera en varias cadenas.
Custom Webhooks son el camino administrado para eventos propios en vivo. Filtras con GraphQL y recibes un callback HTTP del último bloque que la red acepta ahora. No son un almacén histórico. Para el historial, usa Transfers API. Cada callback incluye un sequenceNumber, un entero que incrementa y que puedes usar para notar un bloque reemplazado. Un hueco o un paso hacia atrás en esa secuencia significa que debes volver a pedir esos bloques. Un filtro de topics vacío coincide con cada evento de la dirección y puede salir caro. Define topics cuando conoces el evento.
Construye cuando ninguno de esos endpoints devuelve el registro que tu producto necesita. El health factor de un protocolo de préstamos, las reservas de un AMM después de cada swap, un programa de puntos basado en tu propio evento: eso lo calculas y lo guardas tú. Un subgraph es un indexer empaquetado para ese trabajo. The Graph es el protocolo descentralizado: publicas un subgraph y los indexers lo sirven por GraphQL. Goldsky hospeda subgraphs y transmite datos decodificados a tu propia base. Alchemy Subgraphs se descontinuó el 8 de diciembre de 2025. El aviso de deprecación apunta los subgraphs existentes a Goldsky.
Si estás construyendo el indexer, y eth_getLogs en la flota compartida no cubre el rango, usa un clúster dedicado. El tope de rango compartido existe para que un cliente no desplace a los demás. Un clúster que sirve solo a ti puede subir ese tope. Igual tienes que manejar los bloques reemplazados, guardar el cursor y operar la base.
Preguntas frecuentes
¿Qué es un blockchain indexer?
Un blockchain indexer lee bloques de un nodo, decodifica transacciones y logs de eventos, y los guarda en una base de datos hecha para buscar. Las aplicaciones consultan esa base en lugar de escanear la cadena desde el inicio en cada petición. El nodo sigue siendo de donde salen los datos de la cadena.
¿Cómo funciona un blockchain indexer?
Lee un rango de bloques o logs, decodifica el hex crudo en registros con el ABI del contrato y escribe esos registros en una base de datos. Un número de bloque guardado marca el último bloque que terminaste, así la siguiente corrida continúa desde ahí en lugar de empezar de cero.
¿Debo construir un indexer o usar una API administrada?
Usa una Data API administrada para saldos, historial de transferencias, NFTs y precios. Usa Custom Webhooks cuando necesitas un push de un evento concreto de un contrato. Construye un indexer, o usa un host de subgraphs, cuando necesitas tus propias tablas y ningún endpoint compartido las devuelve.
¿Cómo manejan los indexers los reorgs?
Comparan el parent hash de cada bloque nuevo con el hash que guardaron. Si no coincide, caminan hasta el ancestro común, borran las filas de los bloques reemplazados e indexan los bloques nuevos que la red conservó. Una clave única en cada log evita que una segunda escritura lo inserte dos veces.
¿Qué es un backfill de un indexer?
Un backfill lee bloques viejos por rangos, escribiendo filas decodificadas y un cursor. El cursor se mueve solo después de guardar esas filas, así una caída retoma en un bloque terminado en lugar de dejar un hueco o empezar de nuevo en el bloque cero.
¿Cómo se recupera un indexer después de una caída?
Vuelve a cargar el hash de bloque guardado, confirma que sigue coincidiendo con el nodo y retoma desde el bloque siguiente. Si el hash no coincide, revierte hasta el último bloque que la red conservó y lee hacia adelante otra vez. No saltes los bloques que perdiste. Una clave única en cada log hace seguro escribir esos bloques otra vez.
¿Cuál es la diferencia entre un indexer y un nodo completo?
Un nodo completo guarda la cadena y responde lecturas de bajo nivel como "dame este bloque". Un indexer guarda una respuesta calculada, como "dame las transferencias de esta dirección", y la lee desde una base de datos. La mayoría de las apps necesitan ambos: el nodo para los datos de la cadena y el indexer para la búsqueda.
¿Alchemy aloja subgraphs personalizados?
No. Alchemy Subgraphs se descontinuó el 8 de diciembre de 2025 y esos endpoints de consulta ya no existen. Los subgraphs personalizados pueden moverse a Goldsky. Para lecturas estándar, las Data APIs siguen sirviendo transferencias, tokens, NFTs, precios y portfolios indexados sin alojar un subgraph.
Resúmenes relacionados
 Ethereum
21 de junio de 2022
¿Qué es un reorg?
Qué es, cómo se produce y qué sucede después
 Infra
26 de septiembre de 2023
¿Qué es un subgraph? (Guía)
Aprende cómo funcionan los subgraphs, cómo se pueden usar y cómo empezar a construir
 Infra
15 de junio de 2026
Cómo funciona la infraestructura blockchain dedicada
La infraestructura blockchain dedicada coloca las cargas de trabajo de RPC e indexación en clusters de un solo inquilino. Así funcionan el aislamiento, las regiones, la redundancia y el failover.

Construye magia blockchain
Alchemy combina los productos y herramientas de desarrollo Web3 más potentes con recursos, comunidad y un soporte legendario.