ブロックチェーンインデクサーとは?

執筆者 Usman Asim
ブロックチェーンインデクサーは、ブロックの連鎖をアプリケーションが検索できるデータに変える。ノードはブロック 21,000,000 を返す。それだけでは、あるウォレットへの USDC の全転送も、レンディング契約が開いた全ポジションも返さない。その答えには、誰かがチェーンを読み、ログをデコードし、結果を保存する必要がある。
チームはそのパイプラインを自分で動かすか、すでにその作業を終えたマネージド API を呼ぶ。標準的な質問(トークン残高、転送履歴、NFT、価格)は、たいていマネージド API で足りる。独自の質問(自分のテーブル、自分のイベント、プロトコル状態に対する SQL)は、たいてい自分で運用するインデクサーになる。
ブロックチェーンインデクサーの仕組みは、どちらでも同じ形だ。ブロックを取り出し、レコードに変換し、クエリが見つけられる場所へ載せる。ただし、保存した答えが狂うのは、チェーンが直近のブロックを差し替えたのに古い行を残したとき、履歴を読み終えていないとき、書き込みの途中で処理が止まったときだ。このガイドでは、パイプラインの組み立て方、その3つの場合に何をするか、そのまま動かせるインデックス処理のループ、そしてインデクサーを自前で作るかマネージド API を呼ぶかの判断を扱う。
ブロックチェーンインデクサーとは?
ブロックチェーンインデクサーは、ノードから新しいブロックを読み、トランザクションとイベントログをデコードし、検索向けのデータベースへ書き込むサービスだ。アプリはそのデータベース、またはその前段の API をクエリする。リクエストのたびに最初のブロックからチェーンを読まない。
ブロックチェーンはブロックを順番に保存する。その順序はコンセンサスに必要だ。一つのウォレットを探す役には立たない。ノードに SELECT * FROM transfers WHERE to = ... はない。Ethereum で最も近い呼び出しは eth_getLogs や eth_getBlockByNumber のようなメソッドで、1つのブロック、またはログの1範囲を返す。「このアドレスがしたこと全部」を探すには、その呼び出しを履歴の全体で繰り返し、結果を自分で持つ。
インデクサーはその作業を先にやり、結果を保存する。ウォレット履歴、NFT の所有、DEX の出来高、レンディングのポジションは、計算して出した答えだ。チェーンはそれを読めるフィールドとしては保存しない。
ブロックチェーンインデクサーの仕組みは?
ブロックチェーンインデクサーはループを回す。ブロック範囲を取り、必要なログとトランザクションをデコードし、行を書き、終わった最後のブロックを保存する。次の実行は次のブロックから始まる。最初からチェーンを読み直さない。
ループは3段階だ。
- 抽出。ノードからブロック、レシート、ログを読む。最新に保つには、新しいブロックが追加されるたびに読む。古いブロックに追いつくには、小さい範囲で読む。
- 変換。コントラクト ABI で生の hex をデコードする。トピックのハッシュはイベント名になる。wei の
uint256はトークン量になる。行にタイムスタンプや価格も保存できる。 - ロード。デコードした行をデータベースへ入れる。検索する列(アドレス、コントラクト、token id、ブロック番号)にインデックスを張る。その行を API で返す。
ループはそれだけだ。このページの残りは、チェーンが直近のブロックを差し替えたとき、まだ何年分もの履歴が未読のとき、処理が途中で落ちたときに、保存した行を正しく保つ方法だ。
ブロックチェーンインデクサーのアーキテクチャは?
自分で動かす場合もベンダーの場合も、インデクサーの多くは4つの部品だ。データソース、インデックスエンジン、データベース、API。エンジンは、ログをデコードし、チェーンがブロックを差し替えたときに行を捨て、古いブロックを範囲で読むコードだ。データベースはアプリがクエリするもので、一つのアドレスを探すときに保存した全行を読まなくて済む。
データソース
データソースはノードの JSON-RPC、またはその前段にあるプロバイダのエンドポイントだ。インデクサーは新しいブロック、その中のトランザクション、コントラクトが出したログを求める。インデクサーによってはトレースも読む。トレースはトップレベルの呼び出しだけでなく、トランザクション内部で動いた価値を示す。
インデックスエンジン
インデックスエンジンはノードが返したものをデコードし、何を保存するかを決める。生ログはトピックハッシュの一覧と data フィールドだ。エンジンはコントラクト ABI で、読めるレコードにする。トークン転送、スワップ、清算されたポジション。
現在の残高も持つ。チェーンが保存するのは一つずつの変化であって、「このウォレットは今何を持っているか」への出来合いの答えではない。残高と所有は、これまでの全転送の合計だ。エンジンはその合計を進みながら持つ。あるいは転送を保存し、誰かが聞いたときに合計する。
to_address のデータベースインデックスは、全行を読まずに一つのウォレットの転送を見つける方法だ。
データベース
データベースはデコードした行を持つ。何を聞くかで、どの種類を使うかが決まる。
- PostgreSQL のようなリレーショナルデータベースは、転送、残高、ブロック・アドレス・コントラクトをまたぐ結合に向く。
- ドキュメントストアは、コントラクトごとにフィールドが変わるレコードに向く。
- グラフデータベースは、つながりについての質問に向く。どのウォレットがどのウォレットへトークンを送ったか、どのプールが流動性を共有するか。
- BigQuery のようなウェアハウスは、大きな走査と合計に向く。ページの読み込み中にユーザーが待っているクエリには向かない。
よくある構成は同じ行を2回書く。アプリが読むデータベースへ1回、分析者がクエリするウェアハウスへ1回。
API
API はアプリが呼ぶものだ。GraphQL はクライアントがフィールドを選べる。REST は「このアドレスの転送」のような決まったクエリに向く。websocket や webhook は、行が書かれたときにアプリへ新しい行を送る。アプリは聞き続けなくてよい。
キャッシュ、レート制限、API キーはこの層にあり、1つのクライアントがデータベースを過負荷にできないようにする。
インデクサーはリオーグをどう扱うか?
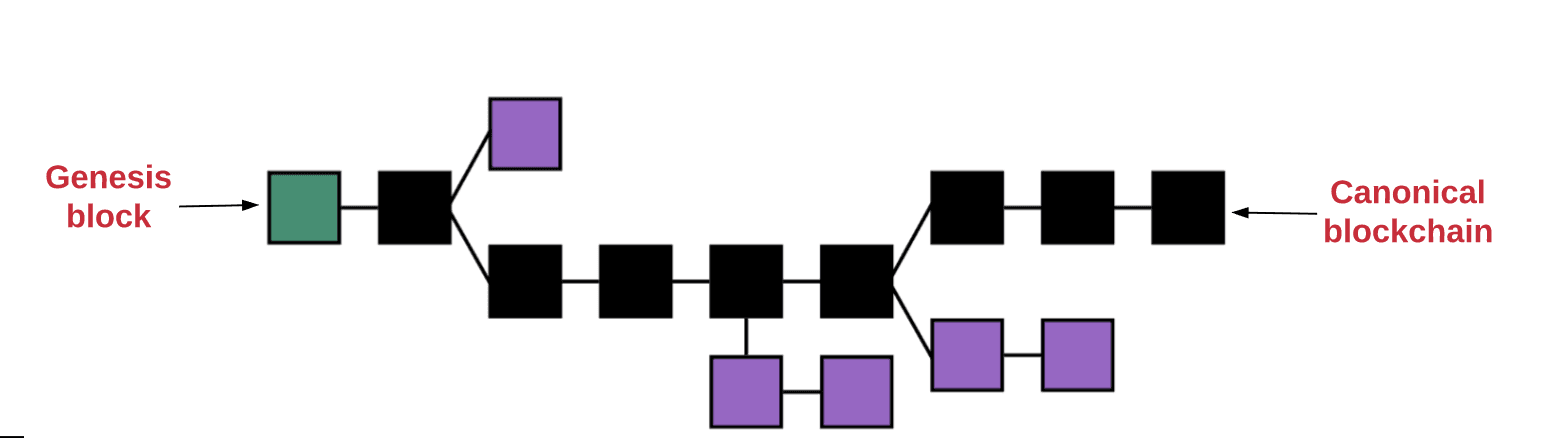
インデクサーは、保存したブロックが最新ブロックの親ではなくなったことに気づき、差し替えられたブロックの行を消し、新しいブロックをインデックスしてリオーグを扱う。その手順を飛ばすと、データベースにはネットワークが残さなかったトランザクションが残る。
リオーグは、コンセンサスが直近の短いブロック列を置き換えるときに起きる。たいてい数ブロックだ。無視すると、ユーザーに見せた転送は着地していなかった、保存した残高は違っていた、という形で出る。
新しいブロックごとの実用的な確認は次のとおりだ。
- 新しいブロックヘッダとその
parentHashを読む。 - そのハッシュを、直前のブロックとして保存したハッシュと比較する。
- 一致すればデコードして挿入する。
- 一致しなければ、共通の祖先が見つかるまで戻る。
- その共通の祖先より後のブロックの行をすべて消す。
- 祖先から、ネットワークが残したブロックに沿って前方へインデックスする。
ログは removed: true で届くこともある。そのフラグは別の挿入ではなく削除として扱う。各行にはチェーンがすでに渡す一意キー、たとえば (chain_id, transaction_hash, log_index) を付ける。同じログを再度書いても二重に数えない。
プロダクトが待てるなら、ノードが finalized または safe と印を付けたブロックだけをインデックスする。それらは、差し替えがまだ起こりやすい地点を過ぎている。少し長く待ち、行を消すことはほとんどなくなる。latest の印が付いたブロックはまだ差し替えられ得る。最新ブロックを追うインデクサーは、それを確定として扱えない。
バックフィルはどう動くか?
バックフィルは古いブロックの最初の読み取りだ。インデクサーは開始ブロックから最新ブロックまで固定レンジで歩き、行を書き、終えた最後のブロックを保存する。再起動はそのブロックから続き、ブロック 0 からやり直さない。
Ethereum の履歴は数千万ブロックだ。1リクエストでは収まらない。通常の道具は eth_getLogs で、頼めるレンジはプランとチェーンによる。無料枠では1回の呼び出しが10ブロックに限られる。Ethereum、Base、Optimism、Arbitrum、Polygon、および eth_getLogs リファレンスの先頭行にあるその他のチェーンでは、従量課金と Enterprise にブロックレンジの上限はない。どのプランでも、応答は150MBで頭打ちだ。その他の大半のチェーンでは、従量課金は1回あたり10,000ブロックまでだ。Monad testnet と Berachain はそれより低い。表がチェーンごとに載っている。それより広いレンジは分割する。バイト上限に当たった応答は、広すぎるレンジと同じように失敗する。
失敗に耐えるバックフィルはこうなる。
- カーソルを保存する。完全にコミットした最後のブロックだ。
- 次のレンジを、そのチェーンとプランの上限未満のサイズで要求する。
- デコードし、行と新しいカーソルを1つのトランザクションでコミットする。
- 保存したブロックが最新ブロックに届くまで繰り返す。
- 古いレンジを読む処理から、新しいブロックを追う処理へ切り替える。
カーソルは、そのレンジの行が保存されてから進める。先にカーソルを進めてから落ちると、そのブロックは永久に飛ばされる。先に行を書いてからカーソルを動かす前に落ちると、次の実行は同じ行を繰り返す。同じログを二度挿入できなければ、それは安全だ。
並列バックフィルはレンジをワーカーに分ける。それでも単一の順序付き保存、またはマージが要る。2つのワーカーが同じブロックの別バージョンを書かないためだ。
インデクサーはどう復旧するか?
復旧とは、ネットワークが残したチェーン上にまだある最後の保存ブロックからやり直して、最新ブロックまで前へ読むことだ。使うコードはバックフィルと同じで、対象のブロック列が短い。
停止後にプロセスが戻ってきたら、保存したブロックがまだ有効だと決めつけない。
- 保存したブロック番号とブロックハッシュを読む。
- そのブロックをノードから取り直す。
- ハッシュがまだ一致すれば、保存したブロックはネットワークが残したものだ。次のブロックから再開する。
- 一致しなければ、停止中にチェーンがブロックを差し替えた。保存したハッシュが一致するまで親ブロックを戻り、データベースをそのブロックまで戻して再開する。
- 最新ブロックに届くまで前へ読む。速く追いつくために欠けたブロックを飛ばさない。そのブロックが、失った転送だ。
避ける失敗は隙間だ。ブロック 18,000,000 は保存済み、ブロック 18,000,500 も保存済み、その間がない。ユーザーは隙間を見ない。欠けた転送と誤った残高を見る。
復旧をいつも通りにする習慣が2つある。一意キーがあれば、同じブロックを再度書いても安全だ。行と同じデータベーストランザクションにカーソルを保存すると、落ちた地点はブロック境界になる。ブロックの途中にはならない。
インデックスのループはコードでどう見えるか?
下のループは Ethereum に対する本物の eth_getLogs バックフィルだ。最新ブロックを読み、10ブロックの窓(無料枠の最大)を歩き、USDC の Transfer ログをそれぞれ表示する。.js ファイルとして保存し、ALCHEMY_API_KEY を設定して、Node 18 以降で実行する。
const url =
"https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

// keccak256("Transfer(address,address,uint256)")
const TRANSFER_TOPIC =
"0xddf252ad1be2c89b69c2b068fc378daa952ba7f163c4a11628f55a4df523b3ef";
const USDC = "0xA0b86991c6218b36c1d19D4a2e9Eb0cE3606eB48";

// Free tier: 10 blocks per eth_getLogs call. Widen this only on a plan
// whose range cap allows it. Responses are capped at 150MB on every plan.
const RANGE = 10;

async function rpc(method, params) {
const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({ jsonrpc: "2.0", id: 1, method, params }),
});
const body = await response.json();
if (body.error) {
  throw new Error(JSON.stringify(body.error));
}
return body.result;
}

async function backfill(fromBlock, toBlock) {
let cursor = fromBlock;
while (cursor <= toBlock) {
  const end = Math.min(cursor + RANGE - 1, toBlock);
  const logs = await rpc("eth_getLogs", [
    {
      fromBlock: "0x" + cursor.toString(16),
      toBlock: "0x" + end.toString(16),
      address: USDC,
      topics: [TRANSFER_TOPIC],
    },
  ]);

  for (const log of logs) {
    // removed: true means the log was on a block that got reorged out.
    if (log.removed) continue;
    const key = log.transactionHash + ":" + log.logIndex;
    console.log(key, log.blockNumber);
  }

  // In a real indexer, commit rows and this cursor in one transaction.
  cursor = end + 1;
}
}

async function main() {
const head = Number(await rpc("eth_blockNumber", []));
await backfill(head - (RANGE - 1), head);
}

main();
本番版は、それらのログを (transaction_hash, log_index) の一意キーでテーブルへ書き、隣にカーソルを保存し、最新ブロックを確定として扱う前にリオーグの節の親ハッシュ確認を走らせる。topics[1] と topics[2] をデコードすると、インデックスされた from と to のアドレスになる。量は data にある。
1つのアドレスの履歴なら、通常このループは回さない。alchemy_getAssetTransfers はその履歴を1ページずつ返す。返った pageKey は、応答から消えるまで次の呼び出しに載せる。1回あたり 120 compute units かかる。eth_getLogs は 60 で、そのうえページング、デコード、保存が残る。
async function main() {
const url =
  "https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    jsonrpc: "2.0",
    id: 1,
    method: "alchemy_getAssetTransfers",
    params: [
      {
        fromBlock: "0x0",
        toAddress: "0x5c43B1eD97e52d009611D89b74fA829FE4ac56b1",
        category: ["external", "erc20", "erc721", "erc1155"],
        withMetadata: true,
        excludeZeroValue: true,
        order: "desc",
        maxCount: "0x64",
      },
    ],
  }),
});

const body = await response.json();
// If body.result.pageKey is set, call again with that pageKey until it is absent.
console.log(body.result.transfers);
}

main();
category は必須だ。値は external、internal、erc20、erc721、erc1155、specialnft。内部転送は Ethereum mainnet、Polygon mainnet、Base mainnet、Arc mainnet、Arc testnet で使える。withMetadata: true はブロックのタイムスタンプを足す。対象は Ethereum、Base、Polygon、Arbitrum、Optimism だ。結果は 1,000 行でページングする。返った pageKey は、応答から消えるまで次の呼び出しに載せる。そのキーは 10 分で期限切れになる。order: "desc" は新しい順だ。order: "asc" は古い順だ。
フォークや部分障害のあいだ、toBlock: "indexed" は最新ブロックではなくインデックス済みキャッシュを読む。その結果は数ブロック遅れることがある。少し古い履歴のほうがエラーよりましなときに使う。
インデクサーを自前で組むか、マネージド API を使うか?
残高、転送、NFT、価格にはマネージド API を使う。自分のテーブルが要るときにインデクサーを組む。独自イベント、ポジション、リザーブ、共有エンドポイントが返さない SQL だ。
Data APIs は、よくある読み取りのマネージドな道だ。Transfers API は、チェーンを走査する代わりに、アドレスの転送履歴を最大 1,000 件ずつのページで返す。external、ERC-20、ERC-721、ERC-1155 の転送を含む。返った pageKey は、応答から消えるまで次の呼び出しに載せる。Token API はメタデータと残高を返す。NFT API は所有を返す。Prices API は現在と過去の価格を返す。Portfolio API はトークン、NFT、転送をまとめ、複数チェーンのウォレット別転送メソッドも含む。
Custom Webhooks は、ライブの独自イベントのマネージドな道だ。GraphQL でフィルタし、ネットワークがいま受け入れている最新ブロックについて HTTP コールバックを受ける。履歴の保管場所ではない。履歴には Transfers API を使う。各コールバックには sequenceNumber がある。増えていく整数で、差し替えられたブロックに気づくために使える。その列の欠番や一歩の後退は、そのブロックを取り直すという意味だ。空のトピックフィルタはそのアドレスの全イベントに一致し、高くなり得る。イベントが分かっているなら topics を指定する。
どのエンドポイントもプロダクトが必要なレコードを返さないときに、自分で組む。レンディングプロトコルのヘルスファクター、スワップのたびに変わる AMM のリザーブ、自分のイベントに基づくポイントプログラム。それは自分で計算して保存する。サブグラフは、その仕事のためのパッケージされたインデクサーだ。The Graph は分散プロトコルだ。サブグラフを公開し、インデクサーが GraphQL で返す。Goldsky はサブグラフをホストし、デコードしたデータを自分のデータベースへ流す。Alchemy Subgraphs は 2025年12月8日に終了した。非推奨の告知は、既存のサブグラフを Goldsky へ向ける。
組んでいるものがインデクサーそのもので、共有フリートの eth_getLogs がレンジを覆えないなら、専用クラスタを使う。共有のレンジ上限は、一人の顧客が他を押しのけないためにある。自分だけに返すクラスタはその上限を上げられる。差し替えられたブロックの処理、カーソルの保存、データベースの運用は、それでも自分でやる。
よくある質問
ブロックチェーンインデクサーとは?
ブロックチェーンインデクサーは、ノードからブロックを読み、トランザクションとイベントログをデコードし、検索向けのデータベースに保存する。アプリケーションはそのデータベースをクエリする。リクエストのたびにチェーンの最初から走査しない。ノードは、チェーンのデータが出てくる場所のままだ。
ブロックチェーンインデクサーの仕組みは?
ブロックまたはログの範囲を読み、コントラクト ABI で生の hex をレコードに変換し、そのレコードをデータベースへ書く。保存したブロック番号は、終えた最後のブロックを示す。次の実行はそこから続き、最初からやり直さない。
インデクサーを自前で組むべきか、マネージド API を使うべきか?
残高、転送履歴、NFT、価格にはマネージドな Data API を使う。特定のコントラクトイベントのプッシュが要るときは Custom Webhooks を使う。自分のテーブルが要り、共有エンドポイントがそれを返さないときは、インデクサーを組むか、サブグラフのホストを使う。
インデクサーはリオーグをどう扱うか?
新しいブロックの親ハッシュを、保存したハッシュと比較する。一致しなければ共通の祖先まで戻り、置き換わったブロックの行を消し、ネットワークが残した新しいブロックをインデックスする。各ログの一意キーは、二度目の書き込みが同じログを二度入れないようにする。
インデクサーのバックフィルとは?
バックフィルは古いブロックをレンジで歩き、デコードした行とカーソルを書きながら進む。カーソルはそれらの行を保存したあとだけ動く。落ちても終えたブロックから再開し、隙間を残したりブロック 0 からやり直したりしない。
停止後にインデクサーをどう復旧するか?
保存したブロックハッシュを読み直し、ノードとまだ一致することを確認して、次のブロックから再開する。一致しなければ、ネットワークが残した最後のブロックまで戻り、前へ読み直す。見逃したブロックは飛ばさない。各ログの一意キーがあれば、そのブロックを再度書いても安全だ。
インデクサーとフルノードの違いは?
フルノードはチェーンを持ち、「このブロックをくれ」のような低レベルの読み取りに答える。インデクサーは「このアドレスの転送をくれ」のような計算した答えを保存し、データベースから読む。ほとんどのアプリは両方が要る。ノードはチェーンのデータ、インデクサーは検索のためだ。
Alchemy はカスタムサブグラフをホストするか?
しない。Alchemy Subgraphs は 2025年12月8日に終了し、それらのクエリ用エンドポイントは廃止された。カスタムサブグラフは Goldsky へ移せる。標準的な読み取りについては、Data APIs がサブグラフをホストせずに、インデックス済みの転送、トークン、NFT、価格、ポートフォリオを返し続ける。
関連する概要


ブロックチェーンで魔法を生み出す
Alchemyは、最も強力なweb3開発者向けプロダクトとツールを、豊富なリソース、コミュニティ、そして卓越したサポートと組み合わせて提供します。