블록체인 인덱서란?

작성자 Usman Asim
블록체인 인덱서는 블록의 사슬을 애플리케이션이 검색할 수 있는 데이터로 바꾼다. 노드는 블록 21,000,000을 반환한다. 그 자체로는 한 지갑으로 온 모든 USDC 전송도, 렌딩 컨트랙트가 연 모든 포지션도 반환하지 않는다. 그 답에는 누군가가 체인을 읽고, 로그를 디코딩하고, 결과를 저장해야 한다.
팀은 그 파이프라인을 직접 돌리거나, 이미 그 작업을 끝낸 관리형 API를 호출한다. 표준 질문(토큰 잔액, 전송 내역, NFT, 가격)은 보통 관리형 API다. 맞춤 질문(자기 테이블, 자기 이벤트, 프로토콜 상태에 대한 SQL)은 보통 직접 운영하는 인덱서다.
블록체인 인덱서의 작동은 어느 쪽이든 같은 모양이다. 블록을 추출하고, 레코드로 변환하고, 쿼리가 찾을 수 있는 곳에 적재한다. 그러나 저장한 답이 틀리는 경우는, 체인이 최근 블록을 바꿔 치웠는데 예전 행을 남겨 둘 때, 과거 기록을 아직 다 읽지 않았을 때, 쓰는 도중에 작업이 멈출 때다. 이 가이드에서는 파이프라인을 어떻게 짜는지, 그 세 경우에 무엇을 하는지, 그대로 실행할 수 있는 인덱싱 루프, 그리고 인덱서를 직접 만들지 관리형 API를 호출할지를 다룬다.
블록체인 인덱서란?
블록체인 인덱서는 노드에서 새 블록을 읽고, 트랜잭션과 이벤트 로그를 디코딩하고, 조회에 맞춘 데이터베이스에 쓰는 서비스다. 앱은 그 데이터베이스, 또는 그 앞의 API를 쿼리한다. 요청마다 첫 블록부터 체인을 읽지 않는다.
블록체인은 블록을 순서대로 저장한다. 그 순서는 합의에 필요하다. 지갑 하나를 찾는 데는 도움이 되지 않는다. 노드에는 SELECT * FROM transfers WHERE to = ...가 없다. Ethereum에서 가장 가까운 호출은 eth_getLogs나 eth_getBlockByNumber 같은 메서드로, 블록 하나 또는 로그 한 범위를 반환한다. "이 주소가 한 모든 일"을 찾으려면 그 호출을 체인 이력 전체에 반복하고, 결과를 직접 보관해야 한다.
인덱서는 그 작업을 미리 하고 결과를 저장한다. 지갑 이력, NFT 소유, DEX 거래량, 렌딩 포지션은 계산해서 낸 답이다. 체인은 그것을 바로 읽을 수 있는 필드로 저장하지 않는다.
블록체인 인덱서는 어떻게 작동하나?
블록체인 인덱서는 루프를 돈다. 블록 범위를 가져오고, 필요한 로그와 트랜잭션을 디코딩하고, 행을 쓰고, 끝낸 마지막 블록을 저장한다. 다음 실행은 다음 블록에서 시작한다. 처음부터 체인을 다시 읽지 않는다.
루프는 세 단계다.
- 추출. 노드에서 블록, 영수증, 로그를 읽는다. 최신으로 유지하려면 새 블록이 추가될 때마다 읽는다. 오래된 블록을 따라잡으려면 작은 범위로 읽는다.
- 변환. 컨트랙트 ABI로 원시 hex를 디코딩한다. 토픽 해시는 이벤트 이름이 된다. wei 단위
uint256은 토큰 수량이 된다. 행에 타임스탬프나 가격도 저장할 수 있다. - 적재. 디코딩한 행을 데이터베이스에 넣는다. 검색할 열(주소, 컨트랙트, token id, 블록 번호)에 인덱스를 둔다. 그 행을 API로 제공한다.
루프는 그게 전부다. 이 페이지의 나머지는 체인이 최근 블록을 바꿔 치울 때, 수년치 이력을 아직 읽지 않았을 때, 프로세스가 중간에 죽을 때 저장한 행을 맞게 유지하는 방법이다.
블록체인 인덱서의 아키텍처는?
직접 돌리든 벤더가 돌리든, 대부분의 인덱서는 네 조각이다. 데이터 소스, 인덱싱 엔진, 데이터베이스, API. 엔진은 로그를 디코딩하고, 체인이 블록을 바꿔 치울 때 행을 버리고, 오래된 블록을 범위로 읽는 코드다. 데이터베이스는 앱이 쿼리하는 곳으로, 주소 하나를 찾을 때 저장한 모든 행을 읽지 않아도 된다.
데이터 소스
데이터 소스는 노드의 JSON-RPC, 또는 그 앞의 제공자 엔드포인트다. 인덱서는 새 블록, 그 블록의 트랜잭션, 컨트랙트가 내보낸 로그를 요청한다. 어떤 인덱서는 트레이스도 읽는다. 트레이스는 최상위 호출만이 아니라 트랜잭션 안에서 이동한 가치를 보여 준다.
인덱싱 엔진
인덱싱 엔진은 노드가 돌려준 것을 디코딩하고 무엇을 저장할지 정한다. 원시 로그는 토픽 해시 목록과 data 필드다. 엔진은 컨트랙트 ABI로 그것을 읽을 수 있는 레코드로 바꾼다. 토큰 전송, 스왑, 청산된 포지션.
현재 잔액도 유지한다. 체인이 저장하는 것은 변화 하나하나이지, "이 지갑이 지금 무엇을 들고 있나"에 대한 완성된 답이 아니다. 잔액과 소유는 지금까지의 모든 전송의 합이다. 엔진은 진행하면서 그 합을 유지하거나, 전송을 저장하고 누군가 물을 때 합을 계산한다.
to_address 데이터베이스 인덱스는 모든 행을 읽지 않고 한 지갑의 전송을 찾는 방법이다.
데이터베이스
데이터베이스는 디코딩한 행을 담는다. 무엇을 묻느냐가 어떤 종류를 쓸지 정한다.
- PostgreSQL 같은 관계형 데이터베이스는 전송, 잔액, 블록·주소·컨트랙트를 가로지르는 조인에 맞다.
- 문서 저장소는 컨트랙트마다 필드가 바뀌는 레코드에 맞다.
- 그래프 데이터베이스는 연결에 대한 질문에 맞다. 어느 지갑이 어느 지갑으로 토큰을 보냈는지, 어느 풀이 유동성을 공유하는지.
- BigQuery 같은 웨어하우스는 큰 스캔과 합계에 맞다. 페이지가 뜨는 동안 사용자가 기다리는 쿼리에는 맞지 않다.
흔한 구성은 같은 행을 두 번 쓴다. 한 번은 앱이 읽는 데이터베이스에, 한 번은 분석가가 쿼리하는 웨어하우스에.
API
API는 앱이 호출하는 것이다. GraphQL은 클라이언트가 필드를 고르게 한다. REST는 "이 주소의 전송"처럼 이미 아는 쿼리에 맞다. websocket이나 webhook은 행이 써질 때 앱에 새 행을 보낸다. 앱이 계속 물어보지 않아도 된다.
캐시, 속도 제한, API 키는 이 계층에 있어서, 한 클라이언트가 데이터베이스를 과부하로 만들지 못하게 한다.
인덱서는 리오그를 어떻게 처리하나?
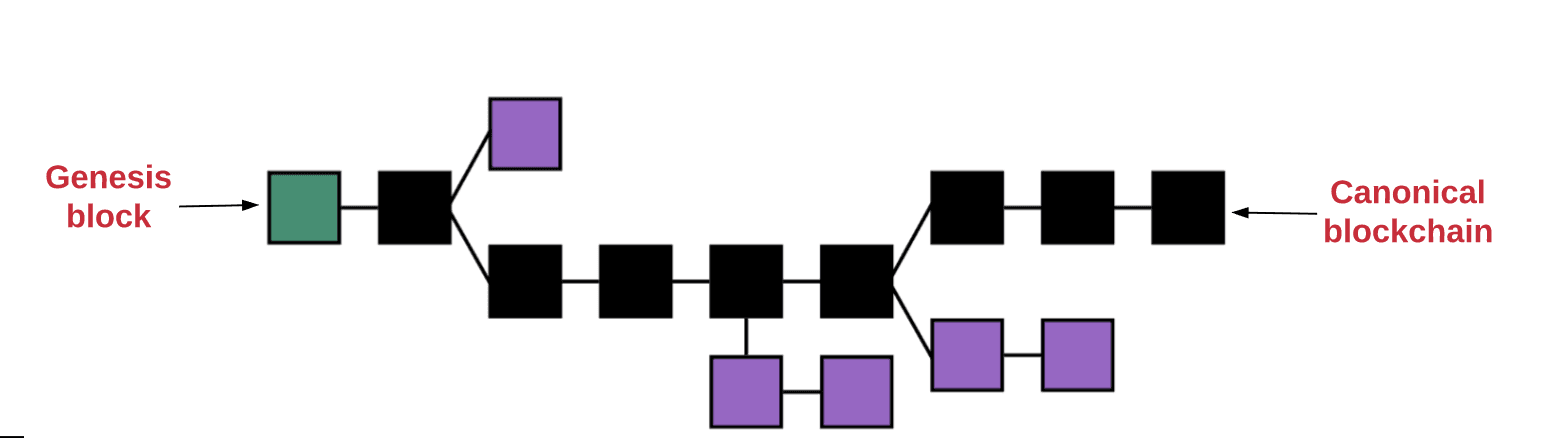
인덱서는 저장된 블록이 더 이상 가장 새 블록의 부모가 아님을 알아채고, 바뀐 블록의 행을 지우고, 새 블록을 인덱싱해서 리오그를 처리한다. 그 단계를 건너뛰면 데이터베이스에는 네트워크가 남기지 않은 트랜잭션이 남는다.
리오그는 합의가 최근 블록의 짧은 구간을 바꿀 때 일어난다. 보통 몇 개뿐이다. 무시하면, 사용자에게 보여 준 전송은 착지하지 않았거나 저장한 잔액이 틀리다.
새 블록마다의 실용적인 확인은 이렇다.
- 새 블록 헤더와 그
parentHash를 읽는다. - 그 해시를 이전 블록으로 저장한 해시와 비교한다.
- 일치하면 디코딩하고 삽입한다.
- 일치하지 않으면 공통 조상을 찾을 때까지 뒤로 걷는다.
- 그 공통 조상 이후 블록의 행을 모두 지운다.
- 조상부터 네트워크가 남긴 블록을 따라 앞으로 인덱싱한다.
로그는 removed: true로 도착할 수도 있다. 그 플래그는 또 다른 삽입이 아니라 삭제로 다룬다. 각 행에 체인이 이미 주는 고유 키를 붙인다. 예를 들어 (chain_id, transaction_hash, log_index). 같은 로그를 다시 써도 두 번 세지 않는다.
제품이 기다릴 수 있다면, 노드가 finalized 또는 safe로 표시한 블록만 인덱싱한다. 그 블록은 교체가 아직 일어날 만한 지점을 지났다. 조금 더 기다리고, 행을 지울 일은 거의 없다. latest로 표시된 블록은 여전히 바뀔 수 있다. 가장 새 블록을 따르는 인덱서는 그것을 영구적인 것으로 다룰 수 없다.
백필은 어떻게 작동하나?
백필은 오래된 블록을 처음 읽는 것이다. 인덱서는 시작 블록부터 가장 새 블록까지 고정 범위로 걷고, 행을 쓰고, 끝낸 마지막 블록을 저장한다. 재시작은 그 블록에서 이어지고, 블록 0에서 다시 시작하지 않는다.
Ethereum의 이력은 수천만 블록이다. 요청 하나로는 담을 수 없다. 보통 도구는 eth_getLogs이고, 요청할 수 있는 범위는 플랜과 체인에 따라 다르다. 무료 티어에서 호출 한 번은 10블록으로 제한된다. Ethereum, Base, Optimism, Arbitrum, Polygon, 그리고 eth_getLogs 레퍼런스 첫 행의 다른 체인에서는 종량제와 Enterprise에 블록 범위 상한이 없다. 모든 플랜에서 응답은 여전히 150MB로 제한된다. 나머지 대부분의 체인에서 종량제는 호출당 10,000블록을 허용한다. Monad testnet과 Berachain은 더 낮다. 표가 체인마다 적혀 있다. 그보다 큰 범위는 나눈다. 바이트 상한에 닿은 응답은 너무 넓은 범위와 같은 방식으로 실패한다.
실패를 견디는 백필은 이렇게 생겼다.
- 커서를 저장한다. 완전히 커밋한 마지막 블록이다.
- 다음 범위를, 그 체인과 플랜의 상한보다 작게 요청한다.
- 디코딩한 뒤 행과 새 커서를 한 트랜잭션으로 커밋한다.
- 저장한 블록이 가장 새 블록에 닿을 때까지 반복한다.
- 오래된 범위를 읽는 방식에서 새 블록을 따르는 방식으로 전환한다.
커서는 그 범위의 행이 저장된 뒤에만 진행한다. 커서를 먼저 진행한 뒤 죽으면 그 블록은 영원히 건너뛴다. 행을 먼저 쓰고 커서가 움직이기 전에 죽으면 다음 실행이 그 행을 반복한다. 같은 로그를 두 번 넣을 수 없으면 안전하다.
병렬 백필은 범위를 워커에 나눈다. 그래도 하나의 순서 있는 저장, 또는 병합 단계가 필요하다. 두 워커가 같은 블록의 다른 버전을 쓰지 않게 하기 위해서다.
인덱서는 어떻게 복구하나?
복구는 네트워크가 남긴 체인에 아직 있는 마지막 저장 블록부터 다시 시작한 다음, 가장 새 블록까지 앞으로 읽는 것이다. 코드는 백필과 같고, 다루는 블록 구간이 더 짧다.
프로세스가 중단 뒤에 돌아오면 저장한 블록이 아직 유효하다고 단정하지 않는다.
- 저장한 블록 번호와 블록 해시를 읽는다.
- 그 블록을 노드에서 다시 가져온다.
- 해시가 여전히 일치하면 저장한 블록은 네트워크가 남긴 것이다. 다음 블록부터 재개한다.
- 일치하지 않으면 내려가 있는 동안 체인이 블록을 바꾼 것이다. 저장한 해시가 일치할 때까지 부모 블록을 뒤로 걷고, 데이터베이스를 그 블록까지 되돌린 뒤 재개한다.
- 가장 새 블록에 닿을 때까지 앞으로 읽는다. 더 빨리 따라잡으려고 빠진 블록을 건너뛰지 않는다. 그 블록이 잃은 전송이다.
피해야 할 실패는 간격이다. 블록 18,000,000은 저장됐고, 블록 18,000,500도 저장됐는데 그 사이가 없다. 사용자는 간격을 보지 않는다. 빠진 전송과 틀린 잔액을 본다.
복구를 일상으로 만드는 습관이 두 가지다. 고유 키는 같은 블록을 다시 써도 안전하게 한다. 행과 같은 데이터베이스 트랜잭션에 커서를 저장하면, 죽음이 블록 경계에서 멈춘다. 블록 한가운데가 아니다.
인덱싱 루프는 코드에서 어떻게 보이나?
아래 루프는 Ethereum에 대한 실제 eth_getLogs 백필이다. 가장 새 블록을 읽고, 10블록 창(무료 티어 최대)을 걷고, USDC Transfer 로그를 각각 출력한다. .js 파일로 저장하고, ALCHEMY_API_KEY를 설정한 뒤 Node 18 이상에서 실행한다.
const url =
"https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

// keccak256("Transfer(address,address,uint256)")
const TRANSFER_TOPIC =
"0xddf252ad1be2c89b69c2b068fc378daa952ba7f163c4a11628f55a4df523b3ef";
const USDC = "0xA0b86991c6218b36c1d19D4a2e9Eb0cE3606eB48";

// Free tier: 10 blocks per eth_getLogs call. Widen this only on a plan
// whose range cap allows it. Responses are capped at 150MB on every plan.
const RANGE = 10;

async function rpc(method, params) {
const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({ jsonrpc: "2.0", id: 1, method, params }),
});
const body = await response.json();
if (body.error) {
  throw new Error(JSON.stringify(body.error));
}
return body.result;
}

async function backfill(fromBlock, toBlock) {
let cursor = fromBlock;
while (cursor <= toBlock) {
  const end = Math.min(cursor + RANGE - 1, toBlock);
  const logs = await rpc("eth_getLogs", [
    {
      fromBlock: "0x" + cursor.toString(16),
      toBlock: "0x" + end.toString(16),
      address: USDC,
      topics: [TRANSFER_TOPIC],
    },
  ]);

  for (const log of logs) {
    // removed: true means the log was on a block that got reorged out.
    if (log.removed) continue;
    const key = log.transactionHash + ":" + log.logIndex;
    console.log(key, log.blockNumber);
  }

  // In a real indexer, commit rows and this cursor in one transaction.
  cursor = end + 1;
}
}

async function main() {
const head = Number(await rpc("eth_blockNumber", []));
await backfill(head - (RANGE - 1), head);
}

main();
프로덕션 버전은 그 로그를 (transaction_hash, log_index)의 고유 키로 테이블에 쓰고, 옆에 커서를 저장하고, 가장 새 블록을 확정으로 다루기 전에 리오그 절의 부모 해시 확인을 실행한다. topics[1]과 topics[2]를 디코딩하면 인덱싱된 from과 to 주소가 나온다. 수량은 data에 있다.
한 주소의 이력이라면 보통 이 루프를 돌리지 않는다. alchemy_getAssetTransfers는 그 이력을 한 페이지씩 반환한다. 반환된 pageKey를 응답에서 빠질 때까지 다음 호출에 넣는다. 호출당 120 compute units가 든다. eth_getLogs는 60이고, 그래도 페이지를 나누고, 디코딩하고, 저장해야 한다.
async function main() {
const url =
  "https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    jsonrpc: "2.0",
    id: 1,
    method: "alchemy_getAssetTransfers",
    params: [
      {
        fromBlock: "0x0",
        toAddress: "0x5c43B1eD97e52d009611D89b74fA829FE4ac56b1",
        category: ["external", "erc20", "erc721", "erc1155"],
        withMetadata: true,
        excludeZeroValue: true,
        order: "desc",
        maxCount: "0x64",
      },
    ],
  }),
});

const body = await response.json();
// If body.result.pageKey is set, call again with that pageKey until it is absent.
console.log(body.result.transfers);
}

main();category는 필수다. 값은 external, internal, erc20, erc721, erc1155, specialnft다. 내부 전송은 Ethereum mainnet, Polygon mainnet, Base mainnet, Arc mainnet, Arc testnet에서 쓸 수 있다. withMetadata: true는 블록 타임스탬프를 더한다. Ethereum, Base, Polygon, Arbitrum, Optimism에서다. 결과는 1,000행에서 페이지가 나뉜다. 반환된 pageKey를 응답에서 빠질 때까지 다음 호출에 넣는다. 그 키는 10분 뒤 만료된다. order: "desc"는 최신순이다. order: "asc"는 오래된 순이다.
포크나 부분 장애 동안 toBlock: "indexed"는 가장 새 블록 대신 인덱싱된 캐시를 읽는다. 그 결과는 몇 블록 뒤처질 수 있다. 약간 더 오래된 이력이 오류보다 나을 때 쓴다.
인덱서를 직접 만들까, 관리형 API를 쓸까?
잔액, 전송, NFT, 가격에는 관리형 API를 쓴다. 자기 테이블이 필요할 때 인덱서를 만든다. 맞춤 이벤트, 포지션, 리저브, 공유 엔드포인트가 반환하지 않는 SQL 쿼리다.
Data APIs는 흔한 읽기의 관리형 경로다. Transfers API는 체인을 훑는 대신 주소의 전송 이력을 최대 1,000건의 페이지로 반환한다. external, ERC-20, ERC-721, ERC-1155 전송을 포함한다. 반환된 pageKey를 응답에서 빠질 때까지 다음 호출에 넣는다. Token API는 메타데이터와 잔액을 반환한다. NFT API는 소유를 반환한다. Prices API는 현재와 과거 가격을 반환한다. Portfolio API는 토큰, NFT, 전송을 묶고, 여러 체인의 지갑별 전송 메서드도 포함한다.
Custom Webhooks는 라이브 맞춤 이벤트의 관리형 경로다. GraphQL로 필터하고, 네트워크가 지금 받아들이는 최신 블록에 대한 HTTP 콜백을 받는다. 이력 저장소가 아니다. 이력은 Transfers API를 쓴다. 각 콜백에는 sequenceNumber가 있다. 증가하는 정수이고, 바뀐 블록을 알아채는 데 쓸 수 있다. 그 수열의 간격이나 한 걸음 뒤는 그 블록을 다시 가져와야 한다는 뜻이다. 빈 토픽 필터는 그 주소의 모든 이벤트와 일치하고 비싸질 수 있다. 이벤트를 알면 topics를 지정한다.
그 엔드포인트 중 어느 것도 제품에 필요한 레코드를 반환하지 않을 때 직접 만든다. 렌딩 프로토콜의 헬스 팩터, 스왑마다 바뀌는 AMM 리저브, 자기 이벤트에 기반한 포인트 프로그램. 그것은 직접 계산해서 저장한다. 서브그래프는 그 일을 위한 패키지된 인덱서다. The Graph는 탈중앙 프로토콜이다. 서브그래프를 게시하면 인덱서가 GraphQL로 제공한다. Goldsky는 서브그래프를 호스트하고 디코딩한 데이터를 자기 데이터베이스로 흘린다. Alchemy Subgraphs는 2025년 12월 8일에 종료됐다. 지원 종료 안내는 기존 서브그래프를 Goldsky로 가리킨다.
만들고 있는 것이 인덱서 자체이고, 공유 플릿의 eth_getLogs가 범위를 덮지 못하면 전용 클러스터를 쓴다. 공유 범위 상한은 한 고객이 다른 고객을 밀어내지 못하게 있다. 자기만 쓰는 클러스터는 그 상한을 올릴 수 있다. 바뀐 블록을 처리하고, 커서를 저장하고, 데이터베이스를 운영하는 일은 여전히 직접 해야 한다.
자주 묻는 질문
블록체인 인덱서란?
블록체인 인덱서는 노드에서 블록을 읽고, 트랜잭션과 이벤트 로그를 디코딩하고, 검색에 맞춘 데이터베이스에 저장한다. 애플리케이션은 그 데이터베이스를 쿼리한다. 요청마다 체인 처음부터 훑지 않는다. 노드는 체인 데이터가 나오는 곳으로 남는다.
블록체인 인덱서는 어떻게 작동하나?
블록이나 로그의 범위를 읽고, 컨트랙트 ABI로 원시 hex를 레코드로 디코딩하고, 그 레코드를 데이터베이스에 쓴다. 저장한 블록 번호는 끝낸 마지막 블록을 표시한다. 다음 실행은 거기서 이어지고, 처음부터 다시 시작하지 않는다.
인덱서를 직접 만들까, 관리형 API를 쓸까?
잔액, 전송 내역, NFT, 가격에는 관리형 Data API를 쓴다. 특정 컨트랙트 이벤트의 푸시가 필요하면 Custom Webhooks를 쓴다. 자기 테이블이 필요하고 공유 엔드포인트가 그것을 반환하지 않으면 인덱서를 만들거나 서브그래프 호스트를 쓴다.
인덱서는 리오그를 어떻게 처리하나?
새 블록의 부모 해시를 저장한 해시와 비교한다. 불일치하면 공통 조상까지 돌아가고, 교체된 블록의 행을 지우고, 네트워크가 남긴 새 블록을 인덱싱한다. 각 로그의 고유 키는 두 번째 쓰기가 같은 로그를 두 번 넣지 않게 한다.
인덱서 백필이란?
백필은 오래된 블록을 범위로 걸으며 디코딩한 행과 커서를 쓴다. 커서는 그 행이 저장된 뒤에만 움직인다. 죽으면 끝낸 블록에서 재개하고, 간격을 남기거나 블록 0에서 다시 시작하지 않는다.
중단 뒤에 인덱서를 어떻게 복구하나?
저장한 블록 해시를 다시 읽고, 노드와 여전히 일치하는지 확인한 뒤 다음 블록부터 재개한다. 일치하지 않으면 네트워크가 남긴 마지막 블록까지 되돌리고 앞으로 다시 읽는다. 놓친 블록은 건너뛰지 않는다. 각 로그의 고유 키가 있으면 그 블록을 다시 써도 안전하다.
인덱서와 풀 노드의 차이는?
풀 노드는 체인을 들고 "이 블록을 줘" 같은 저수준 읽기에 답한다. 인덱서는 "이 주소의 전송을 줘" 같은 계산한 답을 저장하고 데이터베이스에서 읽는다. 대부분의 앱은 둘 다 필요하다. 노드는 체인 데이터용이고, 인덱서는 검색용이다.
Alchemy는 맞춤 서브그래프를 호스트하나?
하지 않는다. Alchemy Subgraphs는 2025년 12월 8일에 종료됐고, 그 쿼리 엔드포인트는 중단됐다. 맞춤 서브그래프는 Goldsky로 옮길 수 있다. 표준 읽기에서 Data APIs는 서브그래프를 호스트하지 않고도 인덱싱된 전송, 토큰, NFT, 가격, 포트폴리오를 계속 제공한다.
관련 개요


블록체인 매직을 만드세요
Alchemy는 가장 강력한 Web3 개발자 제품 및 도구를 리소스, 커뮤니티, 그리고 전설적인 지원과 결합합니다.