O que é um indexador de blockchain?

Escrito por Usman Asim
Um indexador de blockchain transforma uma cadeia de blocos em dados que uma aplicação consegue buscar. Um nó devolve o bloco 21.000.000. Sozinho, ele não devolve cada transferência de USDC para uma carteira, nem cada posição que um contrato de empréstimo abriu. Essas respostas exigem que alguém leia a cadeia, decodifique os logs e guarde o resultado.
Os times rodam esse pipeline ou chamam uma API gerenciada que já fez o trabalho. Perguntas padrão (saldos de tokens, histórico de transferências, NFTs, preços) em geral são uma API gerenciada. Perguntas próprias (suas tabelas, seus eventos, SQL sobre o estado do protocolo) em geral são um indexador que você opera.
O funcionamento dos indexadores de blockchain tem a mesma forma nos dois casos: extrair blocos, transformá-los em registros e carregá-los onde uma consulta consiga encontrá-los. Porém, as respostas guardadas ficam erradas quando a cadeia substitui um bloco recente e você mantém as linhas antigas, quando o histórico ainda não foi lido, ou quando o job para no meio de uma escrita. Neste guia: como o pipeline é montado, o que fazer em cada um desses três casos, um laço de indexação que você pode rodar, e quando construir um indexador ou chamar uma API gerenciada.
O que é um indexador de blockchain?
Um indexador de blockchain é um serviço que lê blocos novos de um nó, decodifica transações e logs de eventos e os grava num banco feito para buscas. Os apps consultam esse banco, ou uma API na frente dele, em vez de ler a cadeia desde o primeiro bloco a cada pedido.
Blockchains guardam blocos em ordem. Essa ordem é o que o consenso precisa. Ela não deixa você procurar uma carteira. Não existe SELECT * FROM transfers WHERE to = ... no nó. A chamada mais próxima no Ethereum é um método como eth_getLogs ou eth_getBlockByNumber, que devolve um bloco, ou um intervalo de logs. Achar "tudo o que esse endereço fez" significa repetir essa chamada ao longo do histórico e guardar o resultado.
Um indexador faz esse trabalho antes e guarda o resultado. Histórico de carteira, posse de NFT, volume de DEX e posições de empréstimo são respostas calculadas. A cadeia não as guarda como um campo que você pode ler.
Como os indexadores de blockchain funcionam?
Um indexador de blockchain roda um loop: puxa um intervalo de blocos, decodifica os logs e as transações que importam, escreve linhas e salva o último bloco que terminou. A próxima execução começa no bloco seguinte. Você não lê a cadeia desde o começo de novo.
O loop tem três etapas.
- Extrair. Lê blocos, recibos ou logs de um nó. Para ficar atualizado, leia cada bloco novo quando ele é adicionado. Para alcançar os blocos antigos, leia-os em intervalos pequenos.
- Transformar. Decodifica o hex bruto com a ABI do contrato. Um hash de topic vira o nome de um evento. Um
uint256em wei vira uma quantidade de tokens. Você também pode guardar um timestamp ou um preço na linha. - Carregar. Insere as linhas decodificadas num banco. Adicione um índice nas colunas que você vai buscar: endereço, contrato, token id, número do bloco. Sirva essas linhas por uma API.
Esse é o loop inteiro. O resto desta página é como manter essas linhas corretas quando a cadeia substitui blocos recentes, quando anos de histórico ainda não foram lidos e quando o processo cai no meio de uma escrita.
Qual é a arquitetura de um indexador de blockchain?
A maioria dos indexadores, operados por você ou por um fornecedor, tem quatro peças: uma fonte de dados, um motor de indexação, um banco e uma API. O motor é o código que decodifica logs, apaga linhas quando a cadeia substitui um bloco e lê blocos antigos em intervalos. O banco é o que o app consulta, para uma busca por um endereço não ler cada linha que você guardou.
Fonte de dados
A fonte de dados é o JSON-RPC do nó ou um endpoint de provedor na frente dele. O indexador pede blocos novos, as transações desses blocos e os logs que os contratos emitiram. Alguns indexadores também leem traces, que mostram valor movido dentro de uma transação, não só a chamada de nível superior.
Motor de indexação
O motor de indexação decodifica o que o nó devolveu e decide o que guardar. Um log bruto é uma lista de hashes de topic mais um campo data. O motor usa a ABI do contrato para transformá-los num registro legível: uma transferência de token, um swap, uma posição liquidada.
Ele também guarda um saldo atual. Uma cadeia guarda cada mudança, não uma resposta pronta para "o que essa carteira tem agora?". Saldos e posse são a soma de cada transferência até aqui. O motor mantém essa soma enquanto avança, ou guarda as transferências e calcula a soma quando alguém pergunta.
Um índice de banco em to_address é como você acha as transferências de uma carteira sem ler cada linha.
Banco de dados
O banco guarda as linhas decodificadas. As perguntas que você faz decidem qual tipo usar:
- Bancos relacionais como PostgreSQL servem para transferências, saldos e joins entre blocos, endereços e contratos.
- Armazenamentos de documentos servem para registros cujos campos mudam de um contrato para o outro.
- Bancos de grafos servem para perguntas sobre conexões: quais carteiras enviaram tokens para quais carteiras, e quais pools compartilham liquidez.
- Warehouses como BigQuery servem para varreduras grandes e totais, não para uma consulta que o usuário espera enquanto a página carrega.
Uma configuração comum escreve as mesmas linhas duas vezes: uma vez no banco que o app lê e outra num warehouse que os analistas consultam.
API
A API é o que o app chama. GraphQL deixa o cliente escolher campos. REST serve para consultas conhecidas, como "transferências deste endereço". Um websocket ou webhook envia ao app uma linha nova quando uma é gravada, para o app não precisar ficar perguntando.
Cache, limites de taxa e API keys ficam nessa camada, para um cliente não sobrecarregar o banco.
Como os indexadores tratam reorgs?
Um indexador trata um reorg ao notar que um bloco guardado não é mais o pai do bloco mais novo, apagar as linhas dos blocos que foram substituídos e indexar os blocos novos. Pule esse passo e o banco ainda contém transações que a rede não manteve.
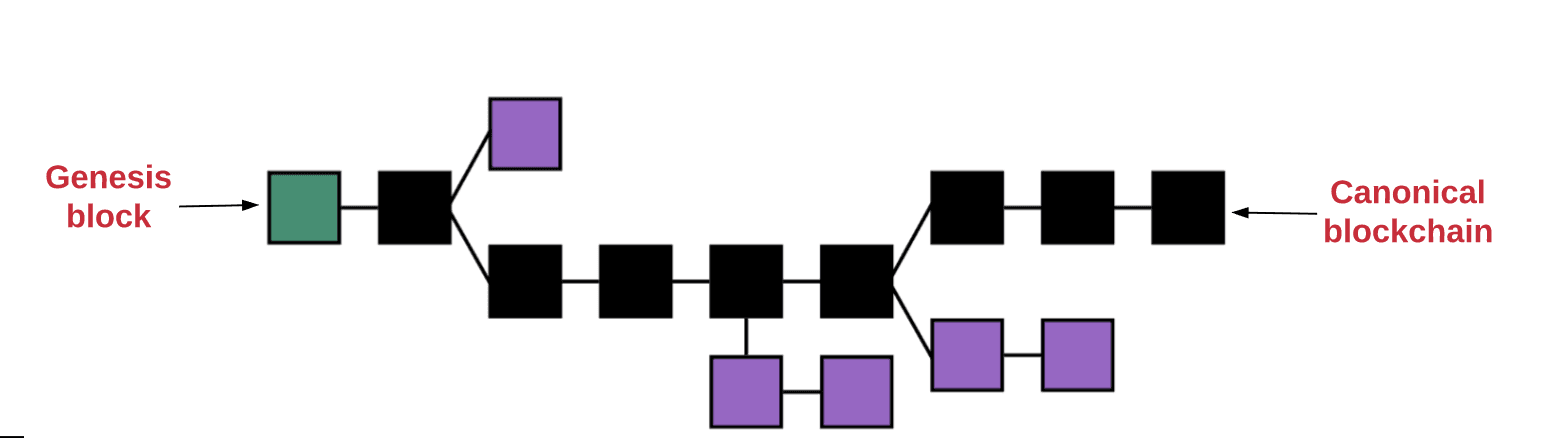
Um reorg acontece quando o consenso substitui um trecho curto de blocos recentes, em geral só alguns. Se você ignorar, uma transferência que você mostrou ao usuário nunca confirmou, ou um saldo que você guardou está errado.
Uma checagem prática em cada bloco novo:
- Leia o header do bloco novo e o
parentHashdele. - Compare esse hash com o hash que você guardou para o bloco anterior.
- Se coincidirem, decodifique e insira.
- Se não, caminhe para trás até o ancestral comum.
- Apague cada linha dos blocos posteriores a esse ancestral compartilhado.
- Indexe para a frente a partir do ancestral, pelos blocos que a rede manteve.
Logs também podem chegar com removed: true. Trate essa marca como uma exclusão, não como outra inserção. Dê a cada linha uma chave única que a cadeia já fornece, como (chain_id, transaction_hash, log_index), para que escrever o mesmo log de novo não o conte duas vezes.
Se o produto pode esperar, indexe só os blocos que o nó marca como finalized ou safe. Esses já passaram do ponto em que uma substituição ainda é provável. Você espera um pouco mais e quase não precisa apagar linhas. Um bloco marcado latest ainda pode ser substituído, então um indexador que segue o bloco mais novo não pode tratá-lo como permanente.
Como um backfill funciona?
Um backfill é a primeira leitura dos blocos antigos. O indexador caminha de um bloco inicial até o bloco mais novo em intervalos fixos, escreve linhas e salva o último bloco concluído. Um reinício continua a partir desse bloco em vez de começar de novo no bloco zero.
O histórico do Ethereum são dezenas de milhões de blocos. Um pedido não comporta isso. eth_getLogs é a ferramenta usual, e o intervalo que você pode pedir depende do plano e da cadeia. No tier gratuito, uma chamada fica limitada a 10 blocos. Em Ethereum, Base, Optimism, Arbitrum, Polygon e as outras cadeias da primeira linha da referência de eth_getLogs, pay as you go e Enterprise não têm teto de intervalo de blocos. Toda resposta, em qualquer plano, continua limitada a 150MB. Na maioria das outras cadeias, pay as you go permite 10.000 blocos por chamada. Monad testnet e Berachain são mais baixos. A tabela lista cada cadeia. Divida qualquer intervalo maior. Uma resposta que bate no teto de bytes falha do mesmo jeito que um intervalo grande demais.
Um backfill que sobrevive a falha fica assim:
- Guarde um cursor: o último bloco que você commitou por completo.
- Peça o próximo intervalo, dimensionado abaixo do teto daquela cadeia e daquele plano.
- Decodifique e depois faça commit das linhas e do cursor novo numa transação.
- Repita até o bloco salvo alcançar o bloco mais novo.
- Passe de ler intervalos antigos para acompanhar blocos novos.
Salve o cursor só depois que as linhas daquele intervalo estiverem salvas. Se você avança o cursor primeiro e depois o processo cai, esses blocos são pulados para sempre. Se você escreve as linhas primeiro e cai antes de mover o cursor, a próxima execução as repete, o que é seguro se o mesmo log não puder ser inserido duas vezes.
Backfills paralelos dividem o intervalo entre workers. Ainda precisam de um salvamento ordenado único, ou de um passo de merge, para dois workers não escreverem versões diferentes do mesmo bloco.
Como você recupera um indexador?
Recuperar significa começar de novo a partir do último bloco salvo que ainda está na cadeia que a rede manteve, e depois ler para a frente até o bloco mais novo. Você usa o mesmo código do backfill, num trecho mais curto de blocos.
Quando um processo volta depois de uma queda, não dê o bloco salvo como válido:
- Carregue o número de bloco guardado e o hash do bloco.
- Busque esse bloco no nó de novo.
- Se o hash ainda coincidir, o bloco salvo ainda é o que a rede manteve. Retome do bloco seguinte.
- Se o hash não coincidir, a cadeia substituiu blocos enquanto você estava fora. Caminhe para trás pelos blocos pai até o hash guardado coincidir, reverta o banco até esse bloco e retome.
- Leia para a frente até o bloco mais novo. Não pule os blocos faltantes para alcançar mais rápido. Esses blocos são as transferências que você perdeu.
A falha a evitar é um buraco: bloco 18.000.000 salvo, bloco 18.000.500 salvo e nada no meio. Usuários não veem o buraco. Veem uma transferência faltando e um saldo errado.
Dois hábitos deixam a recuperação rotineira. Uma chave única torna seguro escrever o mesmo bloco de novo. Salvar o cursor na mesma transação de banco que as linhas faz uma queda parar numa fronteira de bloco, não no meio de um.
Como um loop de indexação aparece no código?
O loop abaixo é um backfill real de eth_getLogs contra o Ethereum. Ele lê o bloco mais novo, percorre uma janela de 10 blocos (o máximo do tier gratuito) e imprime cada log Transfer de USDC. Salve como um arquivo .js, defina ALCHEMY_API_KEY e rode com Node 18 ou mais novo.
const url =
"https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

// keccak256("Transfer(address,address,uint256)")
const TRANSFER_TOPIC =
"0xddf252ad1be2c89b69c2b068fc378daa952ba7f163c4a11628f55a4df523b3ef";
const USDC = "0xA0b86991c6218b36c1d19D4a2e9Eb0cE3606eB48";

// Free tier: 10 blocks per eth_getLogs call. Widen this only on a plan
// whose range cap allows it. Responses are capped at 150MB on every plan.
const RANGE = 10;

async function rpc(method, params) {
const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({ jsonrpc: "2.0", id: 1, method, params }),
});
const body = await response.json();
if (body.error) {
  throw new Error(JSON.stringify(body.error));
}
return body.result;
}

async function backfill(fromBlock, toBlock) {
let cursor = fromBlock;
while (cursor <= toBlock) {
  const end = Math.min(cursor + RANGE - 1, toBlock);
  const logs = await rpc("eth_getLogs", [
    {
      fromBlock: "0x" + cursor.toString(16),
      toBlock: "0x" + end.toString(16),
      address: USDC,
      topics: [TRANSFER_TOPIC],
    },
  ]);

  for (const log of logs) {
    // removed: true means the log was on a block that got reorged out.
    if (log.removed) continue;
    const key = log.transactionHash + ":" + log.logIndex;
    console.log(key, log.blockNumber);
  }

  // In a real indexer, commit rows and this cursor in one transaction.
  cursor = end + 1;
}
}

async function main() {
const head = Number(await rpc("eth_blockNumber", []));
await backfill(head - (RANGE - 1), head);
}

main();
Uma versão de produção grava esses logs numa tabela com chave única em (transaction_hash, log_index), guarda o cursor ao lado e roda a checagem de parent hash da seção de reorgs antes de tratar o bloco mais novo como final. Decodificar topics[1] e topics[2] dá os endereços indexados from e to. O valor fica em data.
Para o histórico de um endereço, em geral você não deveria rodar esse loop. alchemy_getAssetTransfers devolve esse histórico uma página por vez. Envie o pageKey devolvido na chamada seguinte até a resposta omiti-lo. Cada chamada custa 120 compute units. eth_getLogs custa 60, e você ainda precisa paginar, decodificar e guardar.
async function main() {
const url =
  "https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    jsonrpc: "2.0",
    id: 1,
    method: "alchemy_getAssetTransfers",
    params: [
      {
        fromBlock: "0x0",
        toAddress: "0x5c43B1eD97e52d009611D89b74fA829FE4ac56b1",
        category: ["external", "erc20", "erc721", "erc1155"],
        withMetadata: true,
        excludeZeroValue: true,
        order: "desc",
        maxCount: "0x64",
      },
    ],
  }),
});

const body = await response.json();
// If body.result.pageKey is set, call again with that pageKey until it is absent.
console.log(body.result.transfers);
}

main();
category é obrigatório. Os valores são external, internal, erc20, erc721, erc1155 e specialnft. Transferências internas estão disponíveis em Ethereum mainnet, Polygon mainnet, Base mainnet, Arc mainnet e Arc testnet. withMetadata: true adiciona um timestamp de bloco, em Ethereum, Base, Polygon, Arbitrum e Optimism. Os resultados paginam em 1.000 linhas. Envie o pageKey devolvido na chamada seguinte até a resposta omiti-lo. Essa chave expira em 10 minutos. order: "desc" devolve o mais novo primeiro. order: "asc" devolve o mais antigo primeiro.
Durante um fork ou uma queda parcial, toBlock: "indexed" lê do cache indexado em vez do bloco mais novo. Esse resultado pode ficar alguns blocos atrás. Use quando um histórico um pouco mais velho for melhor que um erro.
Você deve construir um indexador ou usar uma API gerenciada?
Use uma API gerenciada para saldos, transferências, NFTs e preços. Construa um indexador quando precisar das suas próprias tabelas: eventos próprios, posições, reservas ou uma consulta SQL que nenhum endpoint compartilhado devolve.
As Data APIs são o caminho gerenciado para as leituras comuns. A Transfers API devolve o histórico de transferências de um endereço em páginas de até 1.000, incluindo externas, ERC-20, ERC-721 e ERC-1155, em vez de varrer a cadeia. Envie o pageKey devolvido na chamada seguinte até a resposta omiti-lo. A Token API devolve metadados e saldos. A NFT API devolve posse. A Prices API devolve preços atuais e históricos. A Portfolio API combina tokens, NFTs e transferências, inclusive um método de transferências por carteira em várias cadeias.
Custom Webhooks são o caminho gerenciado para eventos próprios ao vivo. Você filtra com GraphQL e recebe um callback HTTP do último bloco que a rede aceita agora. Não são um armazenamento histórico. Para histórico, use a Transfers API. Cada callback inclui um sequenceNumber, um inteiro crescente que você pode usar para notar um bloco substituído. Um buraco ou um passo para trás nessa sequência significa que você deve buscar esses blocos de novo. Um filtro de topics vazio casa com todo evento do endereço e pode ficar caro. Defina topics quando souber o evento.
Construa quando nenhum desses endpoints devolve o registro que o seu produto precisa. O health factor de um protocolo de empréstimo, as reservas de um AMM depois de cada swap, um programa de pontos baseado no seu próprio evento: isso você calcula e guarda. Um subgraph é um indexador empacotado para esse trabalho. The Graph é o protocolo descentralizado: você publica um subgraph e indexadores o servem por GraphQL. Goldsky hospeda subgraphs e transmite dados decodificados para o seu banco. Alchemy Subgraphs foi encerrado em 8 de dezembro de 2025. O aviso de descontinuação aponta subgraphs existentes para a Goldsky.
Se você está construindo o indexador, e eth_getLogs na frota compartilhada não cobre o intervalo, use um cluster dedicado. O teto de intervalo compartilhado existe para um cliente não empurrar os outros. Um cluster que serve só você pode subir esse teto. Você ainda tem que tratar os blocos substituídos, salvar o cursor e operar o banco.
Perguntas frequentes
O que é um indexador de blockchain?
Um indexador de blockchain lê blocos de um nó, decodifica transações e logs de eventos e os guarda num banco feito para busca. Aplicações consultam esse banco em vez de varrer a cadeia desde o início a cada pedido. O nó continua sendo de onde saem os dados da cadeia.
Como um indexador de blockchain funciona?
Ele lê um intervalo de blocos ou logs, decodifica o hex bruto em registros com a ABI do contrato e escreve esses registros num banco. Um número de bloco salvo marca o último bloco que você terminou, então a próxima execução continua dali em vez de recomeçar.
Devo construir um indexador ou usar uma API gerenciada?
Use uma Data API gerenciada para saldos, histórico de transferências, NFTs e preços. Use Custom Webhooks quando precisar de um push de um evento específico de contrato. Construa um indexador, ou use um host de subgraphs, quando precisar das suas próprias tabelas e nenhum endpoint compartilhado as devolver.
Como os indexadores tratam reorgs?
Eles comparam o parent hash de cada bloco novo com o hash que guardaram. Se não coincidir, voltam até o ancestral comum, apagam as linhas dos blocos substituídos e indexam os blocos novos que a rede manteve. Uma chave única em cada log impede que uma segunda escrita o insira duas vezes.
O que é um backfill de indexador?
Um backfill lê blocos antigos em intervalos, escrevendo linhas decodificadas e um cursor. O cursor só anda depois que essas linhas são salvas, então uma queda retoma num bloco terminado em vez de deixar um buraco ou recomeçar no bloco zero.
Como recuperar um indexador depois de uma queda?
Recarregue o hash de bloco guardado, confirme que ele ainda coincide com o nó e retome do bloco seguinte. Se o hash não coincidir, reverta até o último bloco que a rede manteve e leia para a frente de novo. Não pule os blocos que você perdeu. Uma chave única em cada log torna seguro escrever esses blocos de novo.
Qual é a diferença entre um indexador e um nó completo?
Um nó completo guarda a cadeia e responde leituras de baixo nível, como "me dê este bloco". Um indexador guarda uma resposta calculada, como "me dê as transferências deste endereço", e a lê a partir de um banco. A maioria dos apps precisa dos dois: o nó para os dados da cadeia e o indexador para a busca.
A Alchemy hospeda subgraphs personalizados?
Não. Alchemy Subgraphs foi encerrado em 8 de dezembro de 2025, e esses endpoints de consulta foram descontinuados. Subgraphs personalizados podem ir para a Goldsky. Para leituras padrão, as Data APIs continuam servindo transferências, tokens, NFTs, preços e portfolios indexados sem hospedar um subgraph.
Visões gerais relacionadas
 Ethereum
21 de junho de 2022
O que é um reorg?
O que é, como acontece e o que vem a seguir
 Infra
26 de setembro de 2023
O que é um subgraph? (Guia)
Aprenda como os subgraphs funcionam, como podem ser usados e como começar a construir
 Infra
15 de junho de 2026
Como funciona a infraestrutura blockchain dedicada
A infraestrutura blockchain dedicada coloca cargas de trabalho de RPC e indexação em clusters single-tenant. Veja como funcionam isolamento, regiões, redundância e failover.

Construa magia blockchain
A Alchemy combina os produtos e ferramentas de desenvolvimento Web3 mais poderosos com recursos, comunidade e suporte lendário.