什么是区块链索引器?

作者 Usman Asim
区块链索引器把一串区块变成应用可以检索的数据。节点会返回区块 21,000,000。它不会自行返回某个钱包收到的每一笔 USDC 转账,也不会返回借贷合约开过的每一个仓位。这些答案需要有人读取链、解码日志并保存结果。
团队要么自己跑这条流水线,要么调用已经做完这件事的托管 API。标准问题(代币余额、转账历史、NFT、价格)通常用托管 API。自定义问题(你自己的表、你自己的事件、针对协议状态的 SQL)通常是你来运营的索引器。
区块链索引器的工作方式无论哪边都是同一形状:提取区块,转换成记录,再载入查询能找到的地方。不过,存下来的答案会错,是在链替换了最近一个区块而你还留着旧行的时候,历史还没读完的时候,或者写入写到一半作业停掉的时候。本指南包括:这条流水线怎么搭、这三种情况分别怎么处理、一段可以直接运行的索引循环,以及何时自建索引器、何时调用托管 API。
什么是区块链索引器?
区块链索引器是一项服务:从节点读取新区块,解码交易和事件日志,写入为查找而建的数据库。应用查询这个数据库,或它前面的 API。每次请求都从第一个区块读起,就不是它要做的事。
区块链按顺序存储区块。这个顺序是共识需要的。它不能用来查找一个钱包。节点上没有 SELECT * FROM transfers WHERE to = ...。Ethereum 上最接近的调用是 eth_getLogs 或 eth_getBlockByNumber 这类方法,返回一个区块,或一段日志。要找到“这个地址做过的一切”,就得在整段历史上重复这次调用,然后自己留住结果。
索引器提前做完这件事,并保存结果。钱包历史、NFT 所有权、DEX 成交量、借贷仓位都是算出来的答案。链不会把它们存成一个可以直接读取的字段。
区块链索引器如何工作?
区块链索引器跑一个循环:拉取一段区块,解码你关心的日志和交易,写入行,并保存你完成的最后一个区块。下一次运行从下一个区块开始。你不会再从开头读整条链。
循环有三个阶段。
- 提取。从节点读取区块、收据或日志。要保持最新,就在每个新区块加入时读取。要补上旧区块,就按小段读取。
- 转换。用合约 ABI 解码原始十六进制。topic 哈希变成事件名。以 wei 计的
uint256变成代币数量。你也可以在行上保存时间戳或价格。 - 载入。把解码后的行插入数据库。在你要搜索的列上建索引:地址、合约、token id、区块号。通过 API 提供这些行。
循环就是这些。这一页其余部分讲的是:链替换最近的区块时、多年历史还没读完时、进程在一次写入中途崩溃时,怎样让这些行保持正确。
区块链索引器的架构是什么?
无论你自己跑还是供应商跑,大多数索引器都是四块:数据源、索引引擎、数据库和 API。引擎是解码日志、在链替换区块时丢掉行、并按段读取旧区块的代码。数据库是应用查询的地方,这样搜索一个地址时不必读完你存下的每一行。
数据源
数据源是节点的 JSON-RPC,或它前面的供应商端点。索引器请求新区块、这些区块里的交易,以及合约发出的日志。有些索引器还读取 trace,trace 显示交易内部移动的价值,不只是顶层调用。
索引引擎
索引引擎解码节点返回的内容,并决定存什么。一条原始日志是一串 topic 哈希加上一个 data 字段。引擎用合约 ABI 把它们变成可读的记录:一笔代币转账、一次交换、一个被清算的仓位。
它也保存当前余额。链存的是每一次变化,不是“这个钱包现在持有什么”的现成答案。余额和所有权是迄今每笔转账的总和。引擎可以边走边维护这个总和,也可以先存转账,有人查询时再求和。
to_address 上的数据库索引,是你找到一个钱包的转账、又不用读每一行的办法。
数据库
数据库保存解码后的行。你要问的问题决定用哪一种:
- PostgreSQL 这类关系数据库适合转账、余额,以及跨区块、地址和合约的连接。
- 文档存储适合字段随合约变化的记录。
- 图数据库适合关于连接的问题:哪些钱包把代币发给了哪些钱包,哪些池共享流动性。
- BigQuery 这类数仓适合大范围扫描和合计,不适合用户在页面加载时正在等待的查询。
常见做法是把同一批行写两次:一次写入应用读取的数据库,一次写入分析师查询的数仓。
API
API 是应用调用的东西。GraphQL 让客户端选择字段。REST 适合已知查询,例如“这个地址的转账”。websocket 或 webhook 在写入一行时把新行发给应用,应用就不用一直去问。
缓存、速率限制和 API 密钥在这一层,这样单个客户端不会让数据库过载。
索引器如何处理重组?
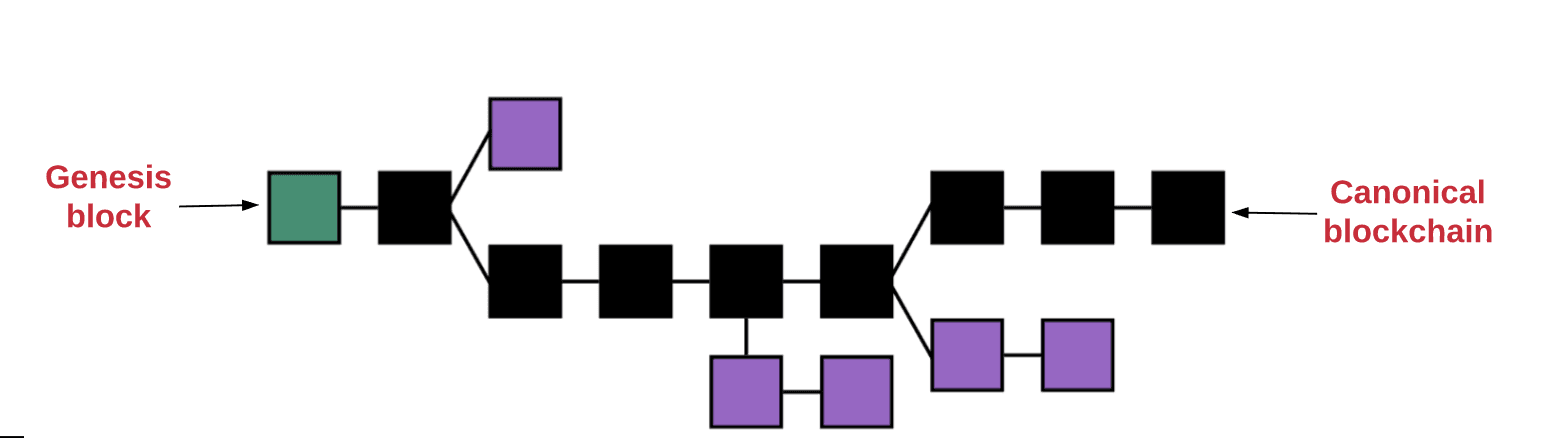
索引器处理重组的方式是:发现已存储的区块不再是最新区块的父块,删除被替换区块上的行,再索引新区块。跳过这一步,数据库里仍然会有网络没有保留的交易。
重组发生在共识替换最近一小段区块时,通常只有几个。如果忽略,你展示给用户的一笔转账从未落地,或者你保存的余额是错的。
每个新区块上的实用检查:
- 读取新区块头及其
parentHash。 - 把这个哈希与你为上一区块存储的哈希比较。
- 若一致,解码并插入。
- 若不一致,向后走到共同祖先。
- 删除这个共同祖先之后那些区块上的每一行。
- 从祖先沿网络保留的区块向前索引。
日志也可能带着 removed: true 到达。把这个标志当作删除,而不是另一次插入。给每一行一个链已经提供的唯一键,例如 (chain_id, transaction_hash, log_index),这样再次写入同一条日志不会把它算两次。
如果产品可以等,只索引节点标为 finalized 或 safe 的区块。这些区块已经过了仍可能被替换的位置。你多等一会儿,就很少需要删行。标为 latest 的区块仍可能被替换,所以跟随最新区块的索引器不能把它当成永久的。
回填如何工作?
回填是对旧区块的第一次读取。索引器从起始区块按固定区间走到最新区块,写入行,并保存最后完成的区块。重启从那个区块继续,而不是从区块 0 重新开始。
Ethereum 的历史有数千万个区块。一次请求装不下。常用工具是 eth_getLogs,能请求的区间取决于套餐和链。在免费档,单次调用限制为 10 个区块。在 Ethereum、Base、Optimism、Arbitrum、Polygon,以及 eth_getLogs 参考第一行的其他链上,按量付费和 Enterprise 没有区块区间上限。每个套餐的每次响应仍限制在 150MB。在其余大多数链上,按量付费每次调用允许 10,000 个区块。Monad testnet 和 Berachain 更低。表里列出了每条链。更大的区间要拆开。撞上字节上限的响应,失败方式和区间过大一样。
能挺过失败的回填是这样的:
- 存储游标:你完整提交的最后一个区块。
- 请求下一段,大小低于该链和该套餐的上限。
- 解码,然后在一个事务里提交行和新游标。
- 重复,直到保存的区块到达最新区块。
- 从读取旧区间切换到跟随新区块。
只在该区间的行已经保存之后才保存游标。如果你先推进游标再崩溃,这些区块会被永远跳过。如果你先写行、在游标移动前崩溃,下一次运行会重复它们。同一条日志不能插入两次时,这是安全的。
并行回填把区间分给多个 worker。它们仍然需要一次有序保存,或一个合并步骤,这样两个 worker 不会写出同一区块的不同版本。
如何恢复索引器?
恢复是从网络保留的链上仍然存在的最后一个已保存区块重新开始,然后向前读到最新区块。你用的代码和回填相同,覆盖的区块更短。
进程在停机后回来时,不要假定保存的区块仍然有效:
- 加载存储的区块号和区块哈希。
- 再次从节点获取该区块。
- 若哈希仍然一致,保存的区块仍是网络保留的那个。从下一个区块继续。
- 若哈希不一致,说明停机期间链替换了区块。沿父块向后走到存储的哈希匹配为止,把数据库回滚到该区块,再继续。
- 向前读,直到最新区块。不要为了更快追上而跳过缺失的区块。那些区块就是你丢失的转账。
要避免的失败是一个缺口:区块 18,000,000 已保存,区块 18,000,500 已保存,中间什么都没有。用户看不到这个缺口。他们看到的是一笔缺失的转账和一个错误的余额。
两个习惯让恢复变成常规操作。唯一键让再次写入同一区块是安全的。把游标和行放在同一次数据库事务里保存,崩溃就会停在区块边界上,而不是停在一个区块的半中间。
索引循环在代码里是什么样?
下面的循环是针对 Ethereum 的一次真实 eth_getLogs 回填。它读取最新区块,走过 10 个区块的窗口(免费档的最大值),并打印每条 USDC Transfer 日志。存成 .js 文件,设置 ALCHEMY_API_KEY,用 Node 18 或更新版本运行。
const url =
"https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

// keccak256("Transfer(address,address,uint256)")
const TRANSFER_TOPIC =
"0xddf252ad1be2c89b69c2b068fc378daa952ba7f163c4a11628f55a4df523b3ef";
const USDC = "0xA0b86991c6218b36c1d19D4a2e9Eb0cE3606eB48";

// Free tier: 10 blocks per eth_getLogs call. Widen this only on a plan
// whose range cap allows it. Responses are capped at 150MB on every plan.
const RANGE = 10;

async function rpc(method, params) {
const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({ jsonrpc: "2.0", id: 1, method, params }),
});
const body = await response.json();
if (body.error) {
  throw new Error(JSON.stringify(body.error));
}
return body.result;
}

async function backfill(fromBlock, toBlock) {
let cursor = fromBlock;
while (cursor <= toBlock) {
  const end = Math.min(cursor + RANGE - 1, toBlock);
  const logs = await rpc("eth_getLogs", [
    {
      fromBlock: "0x" + cursor.toString(16),
      toBlock: "0x" + end.toString(16),
      address: USDC,
      topics: [TRANSFER_TOPIC],
    },
  ]);

  for (const log of logs) {
    // removed: true means the log was on a block that got reorged out.
    if (log.removed) continue;
    const key = log.transactionHash + ":" + log.logIndex;
    console.log(key, log.blockNumber);
  }

  // In a real indexer, commit rows and this cursor in one transaction.
  cursor = end + 1;
}
}

async function main() {
const head = Number(await rpc("eth_blockNumber", []));
await backfill(head - (RANGE - 1), head);
}

main();
生产版本把这些日志写入带 (transaction_hash, log_index) 唯一键的表,把游标存在旁边,并在把最新区块当成最终结果之前运行重组一节里的父哈希检查。解码 topics[1] 和 topics[2] 得到已索引的 from 和 to 地址。金额在 data 里。
对于单个地址的历史,通常不该跑这个循环。alchemy_getAssetTransfers 按页返回这段历史。把返回的 pageKey 放进下一次调用,直到响应里不再有它。每次调用花费 120 个 compute units。eth_getLogs 花费 60,而且你仍要分页、解码和存储。
async function main() {
const url =
  "https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    jsonrpc: "2.0",
    id: 1,
    method: "alchemy_getAssetTransfers",
    params: [
      {
        fromBlock: "0x0",
        toAddress: "0x5c43B1eD97e52d009611D89b74fA829FE4ac56b1",
        category: ["external", "erc20", "erc721", "erc1155"],
        withMetadata: true,
        excludeZeroValue: true,
        order: "desc",
        maxCount: "0x64",
      },
    ],
  }),
});

const body = await response.json();
// If body.result.pageKey is set, call again with that pageKey until it is absent.
console.log(body.result.transfers);
}

main();
category 是必填的。取值是 external、internal、erc20、erc721、erc1155 和 specialnft。内部转账可在 Ethereum mainnet、Polygon mainnet、Base mainnet、Arc mainnet 和 Arc testnet 上使用。withMetadata: true 会加上区块时间戳,适用于 Ethereum、Base、Polygon、Arbitrum 和 Optimism。结果按 1,000 行分页。把返回的 pageKey 放进下一次调用,直到响应里不再有它。这个 key 在 10 分钟后过期。order: "desc" 返回最新的在前。order: "asc" 返回最旧的在前。
在分叉或部分中断期间,toBlock: "indexed" 从已索引缓存读取,而不是从最新区块读取。这个结果可能落后几个区块。当略旧一点的历史好过一次错误时使用它。
应该自建索引器还是使用托管 API?
余额、转账、NFT 和价格使用托管 API。当你需要自己的表时自建索引器:自定义事件、仓位、储备,或任何共享端点都不返回的 SQL 查询。
Data APIs 是常见读取的托管路径。Transfers API 按最多 1,000 条的分页返回一个地址的历史转账,包括外部转账、ERC-20、ERC-721 和 ERC-1155,而不是扫描整条链。把返回的 pageKey 放进下一次调用,直到响应里不再有它。Token API 返回元数据和余额。NFT API 返回所有权。Prices API 返回当前和历史价格。Portfolio API 把代币、NFT 和转账合在一起,包括一个跨链的按钱包查询转账的方法。
Custom Webhooks 是实时自定义事件的托管路径。你用 GraphQL 过滤,并收到网络当前接受的最新区块的 HTTP 回调。它们不是历史存储。历史请用 Transfers API。每个回调包含一个 sequenceNumber,这是一个递增整数,你可以用来发现被替换的区块。这个序列出现缺口或后退一步,就表示你应该重新获取这些区块。空的 topic 过滤会匹配该地址的每个事件,可能很贵。知道事件时就设置 topics。
当这些端点都不返回你的产品需要的记录时,再自建。借贷协议的健康因子、每次交换后 AMM 的储备、基于你自己事件的积分计划:这些由你计算并保存。子图是为这件事打包好的索引器。The Graph 是去中心化协议:你发布子图,索引器通过 GraphQL 提供它。Goldsky 托管子图,并把解码后的数据流入你自己的数据库。Alchemy Subgraphs 已于 2025 年 12 月 8 日停止。弃用说明把现有子图指向 Goldsky。
如果你在建的就是索引器本身,而共享集群上的 eth_getLogs 盖不住区间,就使用专用集群。共享区间上限是为了不让一个客户挤掉其他客户。只服务你的集群可以提高这个上限。你仍然要处理被替换的区块、保存游标,并运行数据库。
常见问题
什么是区块链索引器?
区块链索引器从节点读取区块,解码交易和事件日志,并存入为搜索而建的数据库。应用查询这个数据库,而不是每次请求都从链的起点扫描。节点仍然是链上数据的来源。
区块链索引器如何工作?
它读取一段区块或日志,用合约 ABI 把原始十六进制解码成记录,再把这些记录写入数据库。保存的区块号标出你完成的最后一个区块,下一次运行从那里继续,而不是从头开始。
应该自建索引器还是使用托管 API?
余额、转账历史、NFT 和价格使用托管的 Data API。需要某个具体合约事件的推送时,使用 Custom Webhooks。当你需要自己的表、且没有共享端点返回它们时,自建索引器,或使用子图托管方。
索引器如何处理重组?
它们把每个新区块的父哈希与已存储的哈希比较。不一致时,走回共同祖先,删除被替换区块上的行,并索引网络保留的新区块。每条日志上的唯一键防止第二次写入把同一条日志插入两次。
什么是索引器回填?
回填按区间读取旧区块,边读边写解码后的行和一个游标。游标只在这些行保存之后才移动,因此崩溃会在一个已完成的区块恢复,而不是留下缺口或从区块 0 重来。
停机后如何恢复索引器?
重新加载存储的区块哈希,确认它仍与节点一致,然后从下一个区块继续。若哈希不一致,回滚到网络保留的最后一个区块,再向前读。不要跳过你错过的区块。每条日志上的唯一键让再次写入这些区块是安全的。
索引器和全节点有什么区别?
全节点持有链,并回答“给我这个区块”这类底层读取。索引器保存一个算出来的答案,例如“给我这个地址的转账”,并从数据库读取。大多数应用两者都需要:节点提供链上数据,索引器用来搜索。
Alchemy 是否托管自定义子图?
不托管。Alchemy Subgraphs 已于 2025 年 12 月 8 日停止,那些查询端点已停用。自定义子图可以迁到 Goldsky。对于标准读取,Data APIs 仍提供已索引的转账、代币、NFT、价格和投资组合,而不托管子图。
相关概览


构建区块链应用
Alchemy 将最强大的 Web3 开发者产品和工具与资源、社区及专业支持结合在一起。