什麼是 blockchain indexer?

作者 Usman Asim
區塊鏈索引器把一串區塊變成應用程式可以搜尋的資料。節點會回傳區塊 21,000,000。它不會自己回傳某個錢包收到的每一筆 USDC 轉帳,也不會回傳借貸合約開過的每一個部位。這些答案需要有人讀取鏈、解碼日誌並保存結果。
團隊要嘛自己跑這條管線,要嘛呼叫已經做完這件事的託管 API。標準問題(代幣餘額、轉帳歷史、NFT、價格)通常用託管 API。自訂問題(你自己的表、你自己的事件、針對協定狀態的 SQL)通常是你來營運的索引器。
區塊鏈索引器的運作方式不論哪一邊都是同一形狀:擷取區塊,轉換成紀錄,再載入查詢找得到的地方。不過,存下來的答案會錯,是在鏈替換了最近一個區塊而你還留著舊列的時候,歷史還沒讀完的時候,或是寫入寫到一半行程停掉的時候。本指南包括:這條管線怎麼搭、這三種情況分別怎麼處理、一段可以直接執行的索引迴圈,以及何時自建索引器、何時呼叫託管 API。
什麼是區塊鏈索引器?
區塊鏈索引器是一項服務:從節點讀取新區塊,解碼交易和事件日誌,寫入為查找而建的資料庫。應用程式查詢這個資料庫,或它前面的 API。每次請求都從第一個區塊讀起,就不是它要做的事。
區塊鏈按順序儲存區塊。這個順序是共識需要的。它不能用來查找一個錢包。節點上沒有 SELECT * FROM transfers WHERE to = ...。Ethereum 上最接近的呼叫是 eth_getLogs 或 eth_getBlockByNumber 這類方法,回傳一個區塊,或一段日誌。要找到「這個地址做過的一切」,就得在整段歷史上重複這次呼叫,然後自己留住結果。
索引器提前做完這件事,並保存結果。錢包歷史、NFT 所有權、DEX 成交量、借貸部位都是算出來的答案。鏈不會把它們存成一個可以直接讀取的欄位。
區塊鏈索引器如何運作?
區塊鏈索引器跑一個迴圈:拉取一段區塊,解碼你在意的日誌和交易,寫入列,並保存你完成的最後一個區塊。下一次執行從下一個區塊開始。你不會再從開頭讀整條鏈。
迴圈有三個階段。
- 擷取。從節點讀取區塊、收據或日誌。要保持最新,就在每個新區塊加入時讀取。要補上舊區塊,就按小段讀取。
- 轉換。用合約 ABI 解碼原始十六進位。topic 雜湊變成事件名稱。以 wei 計的
uint256變成代幣數量。你也可以在列上保存時間戳記或價格。 - 載入。把解碼後的列插入資料庫。在你要搜尋的欄上建索引:地址、合約、token id、區塊號。透過 API 提供這些列。
迴圈就是這些。這一頁其餘部分講的是:鏈替換最近的區塊時、多年歷史還沒讀完時、行程在一次寫入中途崩潰時,怎樣讓這些列保持正確。
區塊鏈索引器的架構是什麼?
無論你自己跑還是供應商跑,大多數索引器都是四塊:資料來源、索引引擎、資料庫和 API。引擎是解碼日誌、在鏈替換區塊時丟掉列、並按段讀取舊區塊的程式碼。資料庫是應用程式查詢的地方,這樣搜尋一個地址時不必讀完你存下的每一列。
資料來源
資料來源是節點的 JSON-RPC,或它前面的供應商端點。索引器請求新區塊、這些區塊裡的交易,以及合約發出的日誌。有些索引器還讀取 trace,trace 顯示交易內部移動的價值,不只是頂層呼叫。
索引引擎
索引引擎解碼節點回傳的內容,並決定存什麼。一條原始日誌是一串 topic 雜湊加上一個 data 欄位。引擎用合約 ABI 把它們變成可讀的紀錄:一筆代幣轉帳、一次交換、一個被清算的部位。
它也保存目前餘額。鏈存的是每一次變化,不是「這個錢包現在持有什麼」的現成答案。餘額和所有權是迄今每筆轉帳的總和。引擎可以邊走邊維護這個總和,也可以先存轉帳,有人查詢時再求和。
to_address 上的資料庫索引,是你找到一個錢包的轉帳、又不用讀每一列的辦法。
資料庫
資料庫保存解碼後的列。你要問的問題決定用哪一種:
- PostgreSQL 這類關聯式資料庫適合轉帳、餘額,以及跨區塊、地址和合約的連接。
- 文件儲存適合欄位隨合約變化的紀錄。
- 圖資料庫適合關於連接的問題:哪些錢包把代幣發給了哪些錢包,哪些池共享流動性。
- BigQuery 這類資料倉儲適合大範圍掃描和合計,不適合使用者在頁面載入時正在等待的查詢。
常見做法是把同一批列寫兩次:一次寫入應用程式讀取的資料庫,一次寫入分析師查詢的資料倉儲。
API
API 是應用程式呼叫的東西。GraphQL 讓用戶端選擇欄位。REST 適合已知查詢,例如「這個地址的轉帳」。websocket 或 webhook 在寫入一列時把新列發給應用程式,應用程式就不用一直去問。
快取、速率限制和 API 金鑰在這一層,這樣單一用戶端不會讓資料庫過載。
索引器如何處理重組?
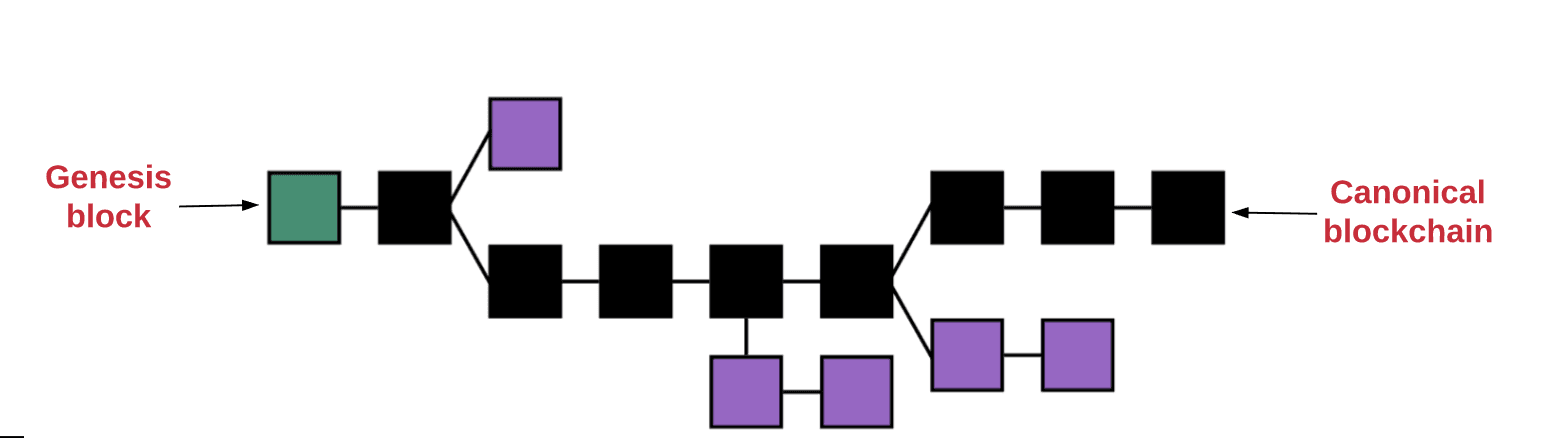
索引器處理重組的方式是:發現已儲存的區塊不再是最新區塊的父塊,刪除被替換區塊上的列,再索引新區塊。跳過這一步,資料庫裡仍然會有網路沒有保留的交易。
重組發生在共識替換最近一小段區塊時,通常只有幾個。如果忽略,你展示給使用者的一筆轉帳從未落地,或者你保存的餘額是錯的。
每個新區塊上的實用檢查:
- 讀取新區塊頭及其
parentHash。 - 把這個雜湊與你為上一區塊儲存的雜湊比較。
- 若一致,解碼並插入。
- 若不一致,向後走到共同祖先。
- 刪除這個共同祖先之後那些區塊上的每一列。
- 從祖先沿網路保留的區塊向前索引。
日誌也可能帶著 removed: true 到達。把這個旗標當作刪除,而不是另一次插入。給每一列一個鏈已經提供的唯一鍵,例如 (chain_id, transaction_hash, log_index),這樣再次寫入同一條日誌不會把它算兩次。
如果產品可以等,只索引節點標為 finalized 或 safe 的區塊。這些區塊已經過了仍可能被替換的位置。你多等一會兒,就很少需要刪列。標為 latest 的區塊仍可能被替換,所以跟隨最新區塊的索引器不能把它當成永久的。
回填如何運作?
回填是對舊區塊的第一次讀取。索引器從起始區塊按固定區間走到最新區塊,寫入列,並保存最後完成的區塊。重新啟動從那個區塊繼續,而不是從區塊 0 重新開始。
Ethereum 的歷史有數千萬個區塊。一次請求裝不下。常用工具是 eth_getLogs,能請求的區間取決於方案和鏈。在免費層,單次呼叫限制為 10 個區塊。在 Ethereum、Base、Optimism、Arbitrum、Polygon,以及 eth_getLogs 參考第一列的其他鏈上,隨用隨付和 Enterprise 沒有區塊區間上限。每個方案的每次回應仍限制在 150MB。在其餘大多數鏈上,隨用隨付每次呼叫允許 10,000 個區塊。Monad testnet 和 Berachain 更低。表裡列出了每條鏈。更大的區間要拆開。撞上位元組上限的回應,失敗方式和區間過大一樣。
能挺過失敗的回填是這樣的:
- 儲存游標:你完整提交的最後一個區塊。
- 請求下一段,大小低於該鏈和該方案的上限。
- 解碼,然後在同一次提交裡寫入列和新游標。
- 重複,直到保存的區塊到達最新區塊。
- 從讀取舊區間切換到跟隨新區塊。
只在該區間的列已經保存之後才保存游標。如果你先推進游標再崩潰,這些區塊會被永遠跳過。如果你先寫列、在游標移動前崩潰,下一次執行會重複它們。同一條日誌不能插入兩次時,這是安全的。
平行回填把區間分給多個 worker。它們仍然需要一次有序保存,或一個合併步驟,這樣兩個 worker 不會寫出同一區塊的不同版本。
如何復原索引器?
復原是從網路保留的鏈上仍然存在的最後一個已保存區塊重新開始,然後向前讀到最新區塊。你用的程式碼和回填相同,涵蓋的區塊更短。
行程在停機後回來時,不要假定保存的區塊仍然有效:
- 載入儲存的區塊號和區塊雜湊。
- 再次從節點取得該區塊。
- 若雜湊仍然一致,保存的區塊仍是網路保留的那個。從下一個區塊繼續。
- 若雜湊不一致,表示停機期間鏈替換了區塊。沿父塊向後走到儲存的雜湊相符為止,把資料庫回滾到該區塊,再繼續。
- 向前讀,直到最新區塊。不要為了更快追上而跳過缺失的區塊。那些區塊就是你遺失的轉帳。
要避免的失敗是一個缺口:區塊 18,000,000 已保存,區塊 18,000,500 已保存,中間什麼都沒有。使用者看不到這個缺口。他們看到的是一筆缺失的轉帳和一個錯誤的餘額。
兩個習慣讓復原變成例行操作。唯一鍵讓再次寫入同一區塊是安全的。把游標和列放在同一次提交裡保存,崩潰就會停在區塊邊界上,而不是停在一個區塊的半中間。
索引迴圈在程式碼裡是什麼樣子?
下面的迴圈是針對 Ethereum 的一次真實 eth_getLogs 回填。它讀取最新區塊,走過 10 個區塊的視窗(免費層的最大值),並列印每條 USDC Transfer 日誌。存成 .js 檔案,設定 ALCHEMY_API_KEY,用 Node 18 或更新版本執行。
const url =
"https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

// keccak256("Transfer(address,address,uint256)")
const TRANSFER_TOPIC =
"0xddf252ad1be2c89b69c2b068fc378daa952ba7f163c4a11628f55a4df523b3ef";
const USDC = "0xA0b86991c6218b36c1d19D4a2e9Eb0cE3606eB48";

// Free tier: 10 blocks per eth_getLogs call. Widen this only on a plan
// whose range cap allows it. Responses are capped at 150MB on every plan.
const RANGE = 10;

async function rpc(method, params) {
const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({ jsonrpc: "2.0", id: 1, method, params }),
});
const body = await response.json();
if (body.error) {
  throw new Error(JSON.stringify(body.error));
}
return body.result;
}

async function backfill(fromBlock, toBlock) {
let cursor = fromBlock;
while (cursor <= toBlock) {
  const end = Math.min(cursor + RANGE - 1, toBlock);
  const logs = await rpc("eth_getLogs", [
    {
      fromBlock: "0x" + cursor.toString(16),
      toBlock: "0x" + end.toString(16),
      address: USDC,
      topics: [TRANSFER_TOPIC],
    },
  ]);

  for (const log of logs) {
    // removed: true means the log was on a block that got reorged out.
    if (log.removed) continue;
    const key = log.transactionHash + ":" + log.logIndex;
    console.log(key, log.blockNumber);
  }

  // In a real indexer, commit rows and this cursor in one transaction.
  cursor = end + 1;
}
}

async function main() {
const head = Number(await rpc("eth_blockNumber", []));
await backfill(head - (RANGE - 1), head);
}

main();
正式版本把這些日誌寫入帶 (transaction_hash, log_index) 唯一鍵的表,把游標存在旁邊,並在把最新區塊當成最終結果之前執行重組一節裡的父雜湊檢查。解碼 topics[1] 和 topics[2] 得到已索引的 from 和 to 地址。金額在 data 裡。
對於單一地址的歷史,通常不該跑這個迴圈。alchemy_getAssetTransfers 按頁回傳這段歷史。把回傳的 pageKey 放進下一次呼叫,直到回應裡不再有它。每次呼叫花費 120 個 compute units。eth_getLogs 花費 60,而且你仍要分頁、解碼和儲存。
async function main() {
const url =
  "https://eth-mainnet.g.alchemy.com/v2/" + process.env.ALCHEMY_API_KEY;

const response = await fetch(url, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    jsonrpc: "2.0",
    id: 1,
    method: "alchemy_getAssetTransfers",
    params: [
      {
        fromBlock: "0x0",
        toAddress: "0x5c43B1eD97e52d009611D89b74fA829FE4ac56b1",
        category: ["external", "erc20", "erc721", "erc1155"],
        withMetadata: true,
        excludeZeroValue: true,
        order: "desc",
        maxCount: "0x64",
      },
    ],
  }),
});

const body = await response.json();
// If body.result.pageKey is set, call again with that pageKey until it is absent.
console.log(body.result.transfers);
}

main();
category 是必填的。取值是 external、internal、erc20、erc721、erc1155 和 specialnft。內部轉帳可在 Ethereum mainnet、Polygon mainnet、Base mainnet、Arc mainnet 和 Arc testnet 上使用。withMetadata: true 會加上區塊時間戳記,適用於 Ethereum、Base、Polygon、Arbitrum 和 Optimism。結果按 1,000 列分頁。把回傳的 pageKey 放進下一次呼叫,直到回應裡不再有它。這個 key 在 10 分鐘後過期。order: "desc" 回傳最新的在前。order: "asc" 回傳最舊的在前。
在分叉或部分中斷期間,toBlock: "indexed" 從已索引快取讀取,而不是從最新區塊讀取。這個結果可能落後幾個區塊。當略舊一點的歷史好過一次錯誤時使用它。
應該自建索引器還是使用託管 API?
餘額、轉帳、NFT 和價格使用託管 API。當你需要自己的表時自建索引器:自訂事件、部位、儲備,或任何共享端點都不回傳的 SQL 查詢。
Data APIs 是常見讀取的託管路徑。Transfers API 按最多 1,000 筆的分頁回傳一個地址的歷史轉帳,包括外部轉帳、ERC-20、ERC-721 和 ERC-1155,而不是掃描整條鏈。把回傳的 pageKey 放進下一次呼叫,直到回應裡不再有它。Token API 回傳中繼資料和餘額。NFT API 回傳所有權。Prices API 回傳目前和歷史價格。Portfolio API 把代幣、NFT 和轉帳合在一起,包括一個跨鏈的按錢包查詢轉帳的方法。
Custom Webhooks 是即時自訂事件的託管路徑。你用 GraphQL 過濾,並收到網路目前接受的最新區塊的 HTTP 回呼。它們不是歷史儲存。歷史請用 Transfers API。每個回呼包含一個 sequenceNumber,這是一個遞增整數,你可以用來發現被替換的區塊。這個序列出現缺口或後退一步,就表示你應該重新取得這些區塊。空的 topic 過濾會符合該地址的每個事件,可能很貴。知道事件時就設定 topics。
當這些端點都不回傳你的產品需要的紀錄時,再自建。借貸協定的健康因子、每次交換後 AMM 的儲備、基於你自己事件的點數計畫:這些由你計算並保存。子圖是為這件事封裝好的索引器。The Graph 是去中心化協定:你發布子圖,索引器透過 GraphQL 提供它。Goldsky 託管子圖,並把解碼後的資料流入你自己的資料庫。Alchemy Subgraphs 已於 2025 年 12 月 8 日停止。棄用說明把現有子圖指向 Goldsky。
如果你在建的就是索引器本身,而共享叢集上的 eth_getLogs 蓋不住區間,就使用專用叢集。共享區間上限是為了不讓一個客戶擠掉其他客戶。只服務你的叢集可以提高這個上限。你仍然要處理被替換的區塊、保存游標,並執行資料庫。
常見問題
什麼是區塊鏈索引器?
區塊鏈索引器從節點讀取區塊,解碼交易和事件日誌,並存入為搜尋而建的資料庫。應用程式查詢這個資料庫,而不是每次請求都從鏈的起點掃描。節點仍然是鏈上資料的來源。
區塊鏈索引器如何運作?
它讀取一段區塊或日誌,用合約 ABI 把原始十六進位解碼成紀錄,再把這些紀錄寫入資料庫。保存的區塊號標出你完成的最後一個區塊,下一次執行從那裡繼續,而不是從頭開始。
應該自建索引器還是使用託管 API?
餘額、轉帳歷史、NFT 和價格使用託管的 Data API。需要某個具體合約事件的推送時,使用 Custom Webhooks。當你需要自己的表、且沒有共享端點回傳它們時,自建索引器,或使用子圖託管方。
索引器如何處理重組?
它們把每個新區塊的父雜湊與已儲存的雜湊比較。不一致時,走回共同祖先,刪除被替換區塊上的列,並索引網路保留的新區塊。每條日誌上的唯一鍵防止第二次寫入把同一條日誌插入兩次。
什麼是索引器回填?
回填按區間讀取舊區塊,邊讀邊寫解碼後的列和一個游標。游標只在這些列保存之後才移動,因此崩潰會在一個已完成的區塊復原,而不是留下缺口或從區塊 0 重來。
停機後如何復原索引器?
重新載入儲存的區塊雜湊,確認它仍與節點一致,然後從下一個區塊繼續。若雜湊不一致,回滾到網路保留的最後一個區塊,再向前讀。不要跳過你錯過的區塊。每條日誌上的唯一鍵讓再次寫入這些區塊是安全的。
索引器和全節點有什麼差別?
全節點持有鏈,並回答「給我這個區塊」這類底層讀取。索引器保存一個算出來的答案,例如「給我這個地址的轉帳」,並從資料庫讀取。大多數應用程式兩者都需要:節點提供鏈上資料,索引器用來搜尋。
Alchemy 是否託管自訂子圖?
不託管。Alchemy Subgraphs 已於 2025 年 12 月 8 日停止,那些查詢端點已停用。自訂子圖可以遷到 Goldsky。對於標準讀取,Data APIs 仍提供已索引的轉帳、代幣、NFT、價格和投資組合,而不託管子圖。
相關總覽


打造區塊鏈魔法
Alchemy 結合最強大的 Web3 開發者產品與工具,並提供資源、社群與卓越的支援。